resubMargin
R2026b再代入分類マージン
説明
例
単純ベイズ分類器の再代入 (標本内) 分類マージンを推定します。観測マージンは、観測された真のクラスのスコアから、該当するクラスのすべてのスコアの中で最大の偽のクラスのスコアを差し引いたものです。
fisheriris データ セットを読み込みます。150 本のアヤメについて 4 つの測定値が含まれる数値行列 X を作成します。対応するアヤメの種類が含まれる文字ベクトルの cell 配列 Y を作成します。
load fisheriris
X = meas;
Y = species;
予測子 X とクラス ラベル Y を使用して、単純ベイズ分類器に学習させます。クラス名を指定することが推奨されます。fitcnb は、各予測子が条件付き正規分布に従うと仮定しています。
Mdl = fitcnb(X,Y,ClassNames=["setosa","versicolor","virginica"])
Mdl =
  ClassificationNaiveBayes
              ResponseName: 'Y'
     CategoricalPredictors: []
                ClassNames: {'setosa'  'versicolor'  'virginica'}
            ScoreTransform: 'none'
           NumObservations: 150
         DistributionNames: {'normal'  'normal'  'normal'  'normal'}
    DistributionParameters: {3×4 cell}


  Properties, Methods
Mdl は学習させた ClassificationNaiveBayes 分類器です。
再代入分類マージンを推定します。
m = resubMargin(Mdl);
median(m)
ans =
1.0000
標本内分類マージンのヒストグラムを表示します。
histogram(m,30,Normalization="probability")
xlabel("In-Sample Margins")
ylabel("Probability")
title("Probability Distribution of the In-Sample Margins")
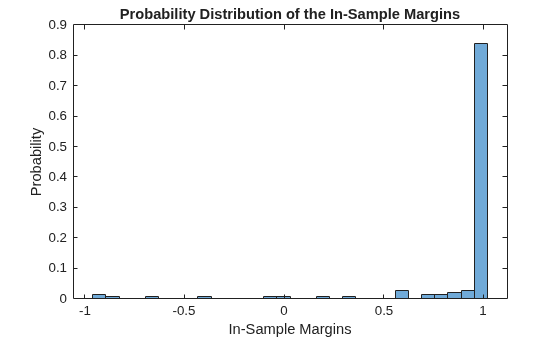
分類器のマージンは比較的大きいことが推奨されます。
複数のモデルによる標本内マージンを比較することにより、特徴選択を実行します。この比較のみに基づくと、マージンが最大である分類器が最適な分類器です。
ionosphere データ セットを読み込みます。次の 2 つのデータ セットを定義します。
fullX。すべての予測子が格納されます (削除された 0 の列を除く)。partX。最後の 20 個の予測子が格納されます。
load ionosphere
fullX = X;
partX = X(:,end-20:end);
予測子セットごとにサポート ベクター マシン (SVM) 分類器に学習させます。
FullSVMModel = fitcsvm(fullX,Y);
PartSVMModel = fitcsvm(partX,Y);
分類器ごとに標本内マージンを推定します。
fullMargins = resubMargin(FullSVMModel);
partMargins = resubMargin(PartSVMModel);
n = size(X,1);
p = sum(fullMargins < partMargins)/n
p =
0.2251
完全なモデルからのマージンの約 22% が、予測子が少ないモデルからのマージンより小さくなっています。この結果は、すべての予測子によって学習をさせたモデルの方が優れていることを示しています。
学習標本マージンおよびエッジを調べて、線形項が含まれる一般化加法モデル (GAM) を線形項と交互作用項の両方が含まれる GAM と比較します。この比較のみに基づくと、マージンおよびエッジが最大である分類器が最適なモデルです。
census1994.mat に保存されている 1994 年の国勢調査データを読み込みます。このデータ セットは、個人の年収が $50,000 を超えるかどうかを予測するための、米国勢調査局の人口統計データから構成されます。この分類タスクでは、年齢、労働階級、教育レベル、婚姻区分、人種などが与えられた人の給与カテゴリを予測するモデルを当てはめます。
load census1994census1994 には学習データ セット adultdata およびテスト データ セット adulttest が含まれています。この例では、実行時間を短縮するために、関数datasampleを使用して adultdata から 500 の学習観測値をサブサンプリングします。
rng("default") % For reproducibility
NumSamples = 5e2;
adultdata = datasample(adultdata,NumSamples,Replace=false);
予測子の線形項と交互作用項の両方が格納されている GAM に学習させます。p 値が 0.05 以下である利用可能な交互作用項をすべて含めるように指定します。
Mdl = fitcgam(adultdata,"salary",Interactions="all",MaxPValue=0.05)
Mdl =
  ClassificationGAM
           PredictorNames: {'age'  'workClass'  'fnlwgt'  'education'  'education_num'  'marital_status'  'occupation'  'relationship'  'race'  'sex'  'capital_gain'  'capital_loss'  'hours_per_week'  'native_country'}
             ResponseName: 'salary'
    CategoricalPredictors: [2 4 6 7 8 9 10 14]
               ClassNames: [<=50K    >50K]
           ScoreTransform: 'logit'
                Intercept: -28.5594
             Interactions: [82×2 double]
          NumObservations: 500


  Properties, Methods
Mdl は ClassificationGAM モデル オブジェクトです。Mdl には 82 個の交互作用項が含まれています。
Mdl の学習標本マージンおよびエッジを推定します。
M = resubMargin(Mdl);
E = resubEdge(Mdl)
E =
1.0000
交互作用項を含めずに Mdl の学習標本マージンおよびエッジを推定します。
M_nointeractions = resubMargin(Mdl,IncludeInteractions=false);
E_nointeractions = resubEdge(Mdl,IncludeInteractions=false)
E_nointeractions =
0.9516
箱ひげ図を使用してマージンの分布を表示します。
boxchart(ones(length(M),1),M)
hold on
boxchart(2*ones(length(M_nointeractions),1),M_nointeractions)
hold off
xticks([1 2])
xticklabels(["Linear and Interaction Terms","Linear Terms Only"])
title("Box Plots of Training Sample Margins")
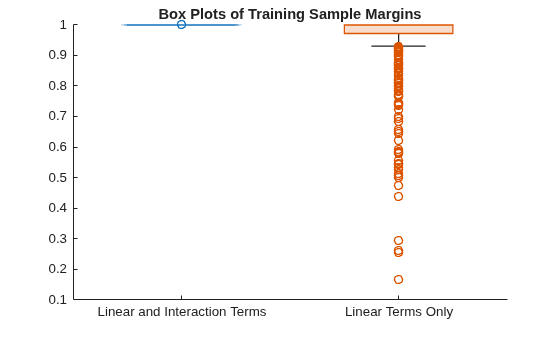
計算に交互作用項を含める場合は、Mdl のすべての再代入マージン値が 1、再代入エッジ値 (マージンの平均) が 1 になります。Mdl に交互作用項を含めない場合、マージンおよびエッジは小さくなります。
入力引数
詳細
アルゴリズム
resubMargin は、オブジェクト (Mdl) の対応する関数 margin に従って分類マージンを計算します。モデル固有の説明については、次の表に示す関数 margin のリファレンス ページを参照してください。
| モデル | 分類モデル オブジェクト (Mdl) | オブジェクト関数 margin |
|---|---|---|
| 一般化加法モデル | ClassificationGAM | margin |
| k 最近傍モデル | ClassificationKNN | margin |
| 単純ベイズ モデル | ClassificationNaiveBayes | margin |
| ニューラル ネットワーク モデル | ClassificationNeuralNetwork | margin |
| 1 クラスおよびバイナリ分類用のサポート ベクター マシン | ClassificationSVM | margin |

