メインコンテンツ

loss

R2026b

線形回帰モデルの回帰損失

説明

L = loss(Mdl,X,Y) は、X 内の予測子データと Y 内の対応する応答を使用して、線形回帰モデル Mdl の平均二乗誤差 (MSE) を返します。L には、Mdl 内の各正則化強度に対する MSE が格納されます。

例

L = loss(Mdl,Tbl,ResponseVarName) は、Tbl 内の予測子データと Tbl.ResponseVarName 内の真の応答に対する MSE を返します。

L = loss(Mdl,Tbl,Y) は、テーブル Tbl 内の予測子データと Y 内の真の応答に対する MSE を返します。

L = loss(___,Name=Value) では、前の構文におけるいずれかの入力引数の組み合わせに加えて、1 つ以上の名前と値の引数を使用してオプションを指定します。たとえば、予測子データの列が観測値に対応することや回帰損失関数を指定します。

例

例

すべて折りたたむ

次のモデルにより、10000 個の観測値のシミュレーションを実行します。

y=x100+2x200+e.

  • X=x1,...,x1000 は、10% の要素が非ゼロ標準正規である 10000 行 1000 列のスパース行列です。

  • e は、平均が 0、標準偏差が 0.3 のランダムな正規誤差です。

rng(1) % For reproducibility
n = 1e4;
d = 1e3;
nz = 0.1;
X = sprandn(n,d,nz);
Y = X(:,100) + 2*X(:,200) + 0.3*randn(n,1);

線形回帰モデルに学習をさせます。観測値の 30% をホールドアウト標本として予約します。

CVMdl = fitrlinear(X,Y,Holdout=0.3);
Mdl = CVMdl.Trained{1}
Mdl = 
  RegressionLinear
         ResponseName: 'Y'
    ResponseTransform: 'none'
                 Beta: [1000×1 double]
                 Bias: -0.0066
               Lambda: 1.4286e-04
              Learner: 'svm'


  Properties, Methods

CVMdl は RegressionPartitionedLinear モデルです。これには Trained プロパティが含まれています。これは 1 行 1 列の cell 配列で、学習セットにより学習させた RegressionLinear モデルが格納されています。

学習データとテスト データを分割の定義から抽出します。

trainIdx = training(CVMdl.Partition);
testIdx = test(CVMdl.Partition);

学習標本とテスト標本の MSE を推定します。

mseTrain = loss(Mdl,X(trainIdx,:),Y(trainIdx))
mseTrain = 
0.1496
mseTest = loss(Mdl,X(testIdx,:),Y(testIdx))
mseTest = 
0.1798

Mdl 内の正則化強度は 1 つなので、mseTrain と mseTest は数値スカラーになります。

次のモデルにより、10000 個の観測値のシミュレーションを実行します。

y=x100+2x200+e.

  • X=x1,...,x1000 は、10% の要素が非ゼロ標準正規である 10000 行 1000 列のスパース行列です。

  • e は、平均が 0、標準偏差が 0.3 のランダムな正規誤差です。

rng(1) % For reproducibility
n = 1e4;
d = 1e3;
nz = 0.1;
X = sprandn(n,d,nz); 
Y = X(:,100) + 2*X(:,200) + 0.3*randn(n,1);
X = X';

線形回帰モデルに学習をさせます。観測値の 30% をホールドアウト標本として予約します。

CVMdl = fitrlinear(X,Y,Holdout=0.3,ObservationsIn="columns"); 
Mdl = CVMdl.Trained{1}
Mdl = 
  RegressionLinear
         ResponseName: 'Y'
    ResponseTransform: 'none'
                 Beta: [1000×1 double]
                 Bias: -0.0066
               Lambda: 1.4286e-04
              Learner: 'svm'


  Properties, Methods

CVMdl は RegressionPartitionedLinear モデルです。これには Trained プロパティが含まれています。これは 1 行 1 列の cell 配列で、学習セットにより学習させた RegressionLinear モデルが格納されています。

学習データとテスト データを分割の定義から抽出します。

trainIdx = training(CVMdl.Partition);
testIdx = test(CVMdl.Partition);

次の Huber 損失 (δ = 1) を評価する無名関数を作成します。

L=1∑wj∑j=1nwjℓj,

ここで

ℓj={0.5ejˆ2;|ejˆ|-0.5;|ejˆ|≤1|ejˆ|>1.

ejˆ は観測値 j の残差です。カスタム損失関数は特定の形式で記述しなければなりません。カスタム損失関数の記述に関するルールについては、名前と値の引数 LossFun を参照してください。

huberloss = @(Y,Yhat,W)sum(W.*((0.5*(abs(Y-Yhat)<=1).*(Y-Yhat).^2) + ...
    ((abs(Y-Yhat)>1).*abs(Y-Yhat)-0.5)))/sum(W);

Huber 損失関数を使用して、学習セットおよびテスト セットの回帰損失を推定します。

eTrain = loss(Mdl,X(:,trainIdx),Y(trainIdx),LossFun=huberloss, ...
    ObservationsIn="columns")
eTrain = 
-0.4186
eTest = loss(Mdl,X(:,testIdx),Y(testIdx),LossFun=huberloss, ...
    ObservationsIn="columns")
eTest = 
-0.4010

次のモデルにより、10000 個の観測値のシミュレーションを実行します。

y=x100+2x200+e.

  • X={x1,...,x1000} は、10% の要素が非ゼロ標準正規である 10000 行 1000 列のスパース行列です。

  • e は、平均が 0、標準偏差が 0.3 のランダムな正規誤差です。

rng(1) % For reproducibility
n = 1e4;
d = 1e3;
nz = 0.1;
X = sprandn(n,d,nz);
Y = X(:,100) + 2*X(:,200) + 0.3*randn(n,1);

10-4 ~ 10-1 の範囲で対数間隔で配置された 15 個の正則化強度を作成します。

Lambda = logspace(-4,-1,15);

データの 30% をテスト用にホールドアウトします。テスト標本のインデックスを識別します。

cvp = cvpartition(numel(Y),Holdout=0.30);
idxTest = test(cvp);

Lambda 内の強度による LASSO ペナルティを使用して、線形回帰モデルに学習をさせます。正則化強度、目的関数を最適化するための SpaRSA の使用、およびデータ分割を指定します。実行速度を向上させるため、予測子データを転置し、観測値が列単位であることを指定します。

X = X'; 
CVMdl = fitrlinear(X,Y,ObservationsIn="columns",Lambda=Lambda, ...
    Solver="sparsa",Regularization="lasso",CVPartition=cvp);
Mdl1 = CVMdl.Trained{1};
numel(Mdl1.Lambda)
ans = 
15

Mdl1 は RegressionLinear モデルです。Lambda は正則化強度の 15 次元ベクトルなので、Mdl1 はそれぞれが正則化強度に対応する 15 個の学習済みモデルであると考えることができます。

各正則化モデルについてテスト標本の平均二乗誤差を推定します。

mse = loss(Mdl1,X(:,idxTest),Y(idxTest),ObservationsIn="columns");

Lambda の値が大きくなると、予測子変数がスパースになります。これは回帰モデルの品質として優れています。データ セット全体と、以前に使用した、データ分割指定以外のすべてのオプションを使用して、モデルに再学習をさせます。モデルごとに非ゼロの係数を特定します。

Mdl = fitrlinear(X,Y,ObservationsIn="columns",Lambda=Lambda, ...
    Solver="sparsa",Regularization="lasso");
numNZCoeff = sum(Mdl.Beta~=0);

同じ図に、各正則化強度についての MSE と非ゼロ係数の頻度をプロットします。すべての変数を対数スケールでプロットします。

figure
yyaxis left
plot(log10(Lambda),log10(mse),"-o")
ylabel("log_{10} MSE")

yyaxis right
plot(log10(Lambda),log10(numNZCoeff),"-o")
ylabel("log_{10} nonzero-coefficient frequency")

xlabel("log_{10} Lambda")
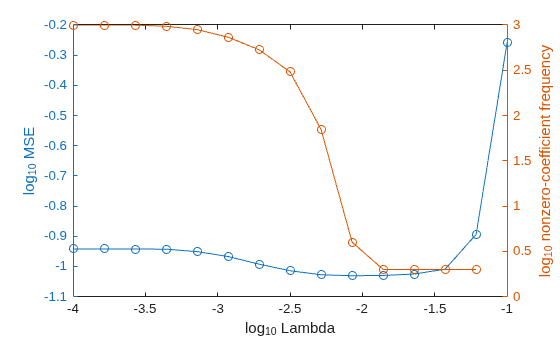
Figure contains an axes object. The axes object with xlabel log indexOf 10 baseline Lambda, ylabel log indexOf 10 baseline nonzero-coefficient frequency contains 2 objects of type line.

最小分類誤差と予測子変数のスパース性のバランスがとれている Lambda のインデックス (Lambda(11) など) を選択します。

idx = 11;
MdlFinal = selectModels(Mdl,idx);

MdlFinal は、正則化強度として Lambda(11) を使用する学習済みの RegressionLinear モデル オブジェクトです。

入力引数

すべて折りたたむ

線形回帰モデル。RegressionLinear モデル オブジェクトとして指定します。RegressionLinear モデル オブジェクトは、fitrlinear を使用して作成できます。

予測子データ。n 行 p 列の完全な行列またはスパース行列を指定します。この X の配置は、各行が個々の観測値に、各列が個々の予測子変数に対応することを示しています。

メモ

観測値が列に対応するように予測子行列を配置して ObservationsIn="columns" を指定すると、計算時間が大幅に短縮される可能性があります。

Y の長さと X の観測値数は同じでなければなりません。

データ型: single | double

応答データ。n 次元の数値ベクトルを指定します。Y の長さは X または Tbl の観測値の数と等しくなければなりません。

データ型: single | double

モデルを学習させるために使用する標本データ。table として指定します。Tbl の各行は 1 つの観測値に、各列は 1 つの予測子変数に対応します。必要に応じて、応答変数用および観測値の重み用の追加列を Tbl に含めることができます。Tbl には、Mdl を学習させるために使用したすべての予測子が含まれていなければなりません。文字ベクトルの cell 配列ではない cell 配列と複数列の変数は使用できません。

Mdl を学習させるために使用した応答変数が Tbl に含まれている場合、ResponseVarName または Y を指定する必要はありません。

テーブルに格納されている標本データを使用して Mdl の学習を行った場合、loss の入力データもテーブルに格納されていなければなりません。

応答変数の名前。Tbl 内の変数の名前で指定します。応答変数は、数値ベクトルでなければなりません。

ResponseVarName を指定する場合は、文字ベクトルまたは string スカラーとして指定しなければなりません。たとえば、応答変数が Tbl.Y として格納されている場合、ResponseVarName として "Y" を指定します。それ以外の場合、Tbl の列は Tbl.Y を含めてすべて予測子として扱われます。

データ型: char | string

名前と値の引数

すべて折りたたむ

オプションの引数のペアを Name1=Value1,...,NameN=ValueN として指定します。ここで、Name は引数名で、Value は対応する値です。名前と値の引数は他の引数の後に指定しなければなりませんが、ペアの順序は重要ではありません。

例: loss(Mdl,Tbl,"Response",Weights="W") は、table Tbl 内の変数 Response および W をそれぞれ応答値および観測値の重みとして使用するように指定します。

損失関数。組み込みの損失関数名または関数ハンドルとして指定します。

  • 次の表は、使用可能な損失関数の一覧です。対応する値を使用していずれかを指定します。また、この表では f(x)=xβ+b. です。

    • β は p 個の係数のベクトルです。

    • x は p 個の予測子変数による観測値です。

    • b はスカラー バイアスです。

    値説明
    "epsiloninsensitive"イプシロン不感応損失: ℓ[y,f(x)]=max[0,|y−f(x)|−ε]
    "mse"MSE: ℓ[y,f(x)]=[y−f(x)]2

    "epsiloninsensitive" は SVM 学習器のみに適しています。

  • 関数ハンドル表記を使用して独自の関数を指定します。

    n を X の観測値数とします。使用する関数のシグネチャは次のようになっていなければなりません。

    lossvalue = lossfun(Y,Yhat,W)
    ここで

    • 出力引数 lossvalue はスカラーです。

    • 関数名 (lossfun) を選択します。

    • Y は観測された応答の n 次元ベクトルです。loss には入力引数 Y で Y を渡します。

    • Yhat は予測された応答の n 次元ベクトルです。これは predict の出力と同様です。

    • W は、観測値の重みの n 行 1 列の数値ベクトルです。

    LossFun=@lossfun を使用して独自の関数を指定します。

例: LossFun="epsiloninsensitive"

データ型: char | string | function_handle

予測子データにおける観測値の次元。"rows" または "columns" として指定します。

メモ

観測値が列に対応するように予測子行列を配置して ObservationsIn="columns" を指定すると、計算時間が大幅に短縮される可能性があります。table の予測子データに対して ObservationsIn="columns" を指定することはできません。

例: ObservationsIn="columns"

データ型: char | string

R2023b 以降

予測子に欠損値がある観測値に使用する予測した応答値。"median"、"mean"、"omitted"、または数値スカラーとして指定します。

値説明
"median"loss は、予測子に欠損値がある観測値について予測した応答値として、学習データ内の観測された応答値の中央値を使用します。
"mean"loss は、予測子に欠損値がある観測値について予測した応答値として、学習データ内の観測された応答値の平均値を使用します。
"omitted"loss は、予測子に欠損値がある観測値を損失の計算から除外します。
数値スカラーloss は、予測子に欠損値がある観測値について予測した応答値として、この値を使用します。

観測された応答値または観測値の重みが観測値にない場合、その観測値は loss による損失の計算に使用されません。

例: PredictionForMissingValue="omitted"

データ型: single | double | char | string

観測値の重み。数値ベクトルまたは Tbl 内の変数の名前を指定します。

  • Weights として数値ベクトルを指定する場合、Weights のサイズは X または Tbl 内の観測値の個数と等しくなければなりません。

  • Weights として Tbl 内の変数名を指定する場合、名前は文字ベクトルまたは string スカラーでなければなりません。たとえば、重みが Tbl.W として格納されている場合、Weights として "W" を指定します。それ以外の場合、Tbl の列は Tbl.W を含めてすべて予測子として扱われます。

重みを指定した場合、loss は加重回帰損失を計算し、合計が 1 になるように Weights を正規化します。

データ型: double | single

出力引数

すべて折りたたむ

回帰損失。数値スカラーまたは行ベクトルとして返されます。L の解釈は Weights と LossFun によって異なります。

L のサイズは Mdl.Lambda と同じになります。L(j) は、正則化強度 Mdl.Lambda(j) を使用して学習をさせた線形回帰モデルの回帰損失です。

メモ

Mdl.FittedLoss が "mse" の場合、目的関数の損失項は MSE の半分になります。既定の設定では、loss は MSE を返します。したがって、loss を使用して再代入 (学習) 誤差をチェックした場合、fitrlinear によって返される最適化結果と MSE が異なります。

拡張機能

すべて展開する

バージョン履歴

R2016a で導入

すべて展開する