このページの内容は最新ではありません。最新版の英語を参照するには、ここをクリックします。
loss
R2026aニューラル ネットワーク分類器の分類損失
説明
L = loss(___,Name,Value)
メモ
X または Tbl の予測子データに欠損値があり、LossFun が "classifcost"、"classiferror"、または "mincost" に設定されていない場合、関数 loss で NaN が返されることがあります。詳細については、欠損値がある予測子データに対して loss で NaN が返されることがあるを参照してください。
例
ニューラル ネットワーク分類器のテスト セットの分類誤差を計算します。
patients データ セットを読み込みます。データ セットから table を作成します。各行が 1 人の患者に対応し、各列が診断の変数に対応します。変数 Smoker を応答変数として使用し、残りの変数を予測子として使用します。
load patients
tbl = table(Diastolic,Systolic,Gender,Height,Weight,Age,Smoker);
層化ホールドアウト分割を使用して、データを学習セット tblTrain とテスト セット tblTest に分割します。観測値の約 30% がテスト データ セット用に予約され、残りの観測値が学習データ セットに使用されます。
rng("default") % For reproducibility of the partition
c = cvpartition(tbl.Smoker,"Holdout",0.30);
trainingIndices = training(c);
testIndices = test(c);
tblTrain = tbl(trainingIndices,:);
tblTest = tbl(testIndices,:);
学習セットを使用してニューラル ネットワーク分類器に学習させます。tblTrain の列 Smoker を応答変数として指定します。数値予測子を標準化するための指定を行います。
Mdl = fitcnet(tblTrain,"Smoker", ...
    "Standardize",true);
テスト セットの分類誤差を計算します。分類誤差は、ニューラル ネットワーク分類器の既定の損失タイプです。
testError = loss(Mdl,tblTest,"Smoker")testError = 0.0671
testAccuracy = 1 - testError
testAccuracy =
0.9329
テスト セットの観測値の約 93% がニューラル ネットワーク モデルで正しく分類されています。
テスト セットの分類マージン、エッジ、誤差、予測を比較することにより、特徴選択を実行します。すべての予測子を使用して学習させたモデルのテスト セット メトリクスを予測子のサブセットのみを使用して学習させたモデルのテスト セット メトリクスと比較します。
標本ファイル fisheriris.csv を読み込みます。これには、アヤメについてのがく片の長さ、がく片の幅、花弁の長さ、花弁の幅、種の種類などのデータが格納されています。ファイルを table に読み込みます。
fishertable = readtable('fisheriris.csv');層化ホールドアウト分割を使用して、データを学習セット trainTbl とテスト セット testTbl に分割します。観測値の約 30% がテスト データ セット用に予約され、残りの観測値が学習データ セットに使用されます。
rng("default")
c = cvpartition(fishertable.Species,"Holdout",0.3);
trainTbl = fishertable(training(c),:);
testTbl = fishertable(test(c),:);
学習セット内のすべての予測子を使用して 1 つのニューラル ネットワーク分類器に学習させ、PetalWidth を除くすべての予測子を使用してもう 1 つの分類器に学習させます。両方のモデルについて、Species を応答変数として指定し、予測子を標準化します。
allMdl = fitcnet(trainTbl,"Species","Standardize",true);
subsetMdl = fitcnet(trainTbl,"Species ~ SepalLength + SepalWidth + PetalLength", ...
    "Standardize",true);
2 つのモデルのテスト セットの分類マージンを計算します。テスト セットに含まれる観測値は 45 個だけであるため、棒グラフを使用してマージンを表示します。
各観測値の分類マージンは、真のクラスの分類スコアと偽のクラスの最大スコアの差を表します。ニューラル ネットワーク分類器から返される分類スコアは事後確率であるため、マージンの値が 1 に近いほど信頼度が高い分類であることを示し、負のマージンの値は誤分類を示します。
tiledlayout(2,1)

% Top axes
ax1 = nexttile;
allMargins = margin(allMdl,testTbl);
bar(ax1,allMargins)
xlabel(ax1,"Observation")
ylabel(ax1,"Margin")
title(ax1,"All Predictors")

% Bottom axes
ax2 = nexttile;
subsetMargins = margin(subsetMdl,testTbl);
bar(ax2,subsetMargins)
xlabel(ax2,"Observation")
ylabel(ax2,"Margin")
title(ax2,"Subset of Predictors")

2 つのモデルのテスト セットの分類エッジ (分類マージンの平均) を比較します。
allEdge = edge(allMdl,testTbl)
allEdge =
0.8198
subsetEdge = edge(subsetMdl,testTbl)
subsetEdge =
0.9556
テスト セットの分類マージンと分類エッジからは、予測子のサブセットで学習させたモデルの方がすべての予測子で学習させたモデルよりも性能が優れていると考えられます。
2 つのモデルのテスト セットの分類誤差を比較します。
allError = loss(allMdl,testTbl);
allAccuracy = 1-allError
allAccuracy =
0.9111
subsetError = loss(subsetMdl,testTbl);
subsetAccuracy = 1-subsetError
subsetAccuracy =
0.9778
この場合も、予測子のサブセットのみを使用して学習させたモデルの方がすべての予測子を使用して学習させたモデルよりも性能が優れていることがわかります。
混同行列を使用してテスト セットの分類結果を可視化します。
allLabels = predict(allMdl,testTbl);
figure
confusionchart(testTbl.Species,allLabels)
title("All Predictors")
subsetLabels = predict(subsetMdl,testTbl);
figure
confusionchart(testTbl.Species,subsetLabels)
title("Subset of Predictors")
すべての予測子を使用して学習させたモデルには、テスト セットの観測値の誤分類が 4 件あります。予測子のサブセットを使用して学習させたモデルでは、テスト セットの観測値の誤分類は 1 件だけです。
2 つのモデルのテスト セットの性能から、PetalWidth を除くすべての予測子を使用して学習させたモデルを使用することを検討します。
入力引数
名前と値の引数
詳細
"分類損失" 関数は分類モデルの予測誤差を評価します。複数のモデルで同じタイプの損失を比較した場合、損失が低い方が予測モデルとして優れていることになります。
以下のシナリオを考えます。
L は加重平均分類損失です。
n は標本サイズです。
バイナリ分類は以下です。
yj は観測されたクラス ラベルです。陰性クラスを示す -1 または陽性クラスを示す 1 (あるいは、
ClassNamesプロパティの最初のクラスを示す -1 または 2 番目のクラスを示す 1) を使用して符号化されます。f(Xj) は予測子データ X の観測値 (行) j に対する陽性クラスの分類スコアです。
mj = yjf(Xj) は、yj に対応するクラスに観測値 j を分類する分類スコアです。正の値の mj は正しい分類を示しており、平均損失に対する寄与は大きくありません。負の値の mj は正しくない分類を示しており、平均損失に大きく寄与します。
マルチクラス分類 (つまり、K ≥ 3) をサポートするアルゴリズムの場合、次のようになります。
yj* は、K - 1 個の 0 と、観測された真のクラス yj に対応する位置の 1 から構成されるベクトルです。たとえば、2 番目の観測値の真のクラスが 3 番目のクラスであり K = 4 の場合、y2* = [
0 0 1 0]′ になります。クラスの順序は入力モデルのClassNamesプロパティ内の順序に対応します。f(Xj) は予測子データ X の観測値 j に対するクラス スコアのベクトルで、長さは K です。スコアの順序は入力モデルの
ClassNamesプロパティ内のクラスの順序に対応します。mj = yj*′f(Xj).したがって mj は、観測された真のクラスについてモデルが予測するスカラー分類スコアです。
観測値 j の重みは wj です。観測値の重みは、その合計が
Priorプロパティに格納された対応するクラスの事前確率になるように正規化されます。そのため、次のようになります。
この状況では、名前と値の引数 LossFun を使用して指定できる、サポートされる損失関数は次の表のようになります。
| 損失関数 | LossFun の値 | 式 |
|---|---|---|
| 二項分布からの逸脱度 | "binodeviance" | |
| 観測誤分類コスト | "classifcost" | ここで、 はスコアが最大のクラスに対応するクラス ラベル、 は真のクラスが yj である場合に観測値をクラス に分類するユーザー指定のコストです。 |
| 10 進数の誤分類率 | "classiferror" | ここで、I{·} はインジケーター関数です。 |
| クロスエントロピー損失 | "crossentropy" |
加重クロスエントロピー損失は次となります。 ここで重み は、合計が 1 ではなく n になるように正規化されます。 |
| 指数損失 | "exponential" | |
| ヒンジ損失 | "hinge" | |
| ロジスティック損失 | "logit" | |
| 最小予測誤分類コスト | "mincost" |
重み付きの最小予測分類コストは、次の手順を観測値 j = 1、...、n について使用することにより計算されます。
最小予測誤分類コスト損失の加重平均は次となります。 |
| 二次損失 | "quadratic" |
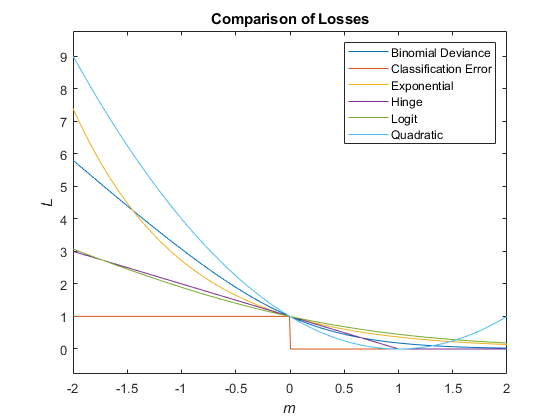
既定のコスト行列 (正しい分類の場合の要素値は 0、誤った分類の場合の要素値は 1) を使用する場合、"classifcost"、"classiferror"、および "mincost" の損失の値は同じです。既定以外のコスト行列をもつモデルでは、ほとんどの場合は "classifcost" の損失と "mincost" の損失が等価になります。これらの損失が異なる値になる可能性があるのは、最大の事後確率をもつクラスへの予測と最小の予測コストをもつクラスへの予測が異なる場合です。"mincost" は分類スコアが事後確率の場合にしか適さないことに注意してください。
次の図では、1 つの観測値のスコア m に対する損失関数 ("classifcost"、"crossentropy"、および "mincost" を除く) を比較しています。いくつかの関数は、点 (0,1) を通過するように正規化されています。