メインコンテンツ

lsqcurvefit

R2026b

非線形曲線近似 (データ適合) 問題を最小二乗近似的に解く

説明

非線形最小二乗ソルバー

問題を解く係数 x を見つけます

minx‖F(x,xdata)−ydata‖22=minx∑i(F(x,xdatai)−ydatai)2,

xdata は入力データ、ydata は観測された出力です。ここで、xdata および ydata は行列またはベクトル、F (x, xdata) は ydata と同サイズの行列値またはベクトル値関数です。

オプションとして、x の成分は以下の制約に従います。

lb≤xx≤ubAx≤bAeqx=beqc(x)≤0ceq(x)=0.

引数 x、lb、および ub はベクトルまたは行列とすることができます。行列引数 を参照してください。

関数 lsqcurvefit は lsqnonlin と同じアルゴリズムを使用します。lsqcurvefit の目的は単にデータ適合問題用に便利なインターフェイスを与えることです。

二乗和を計算するというよりもむしろ、lsqcurvefit は次のベクトル値関数を計算するユーザー定義関数を必要とします。

F(x,xdata)=[F(x,xdata)(1)F(x,xdata)(2)⋮F(x,xdata)(k)].

x = lsqcurvefit(fun,x0,xdata,ydata) は、x0 を開始値として、非線形関数 fun(x,xdata) がデータ ydata に (最小二乗的に) 最も合う係数 x を求めます。ydata は、fun が返すベクトル (または行列) F と同じサイズでなければなりません。

メモ

追加パラメーターの受け渡し は必要に応じて他のパラメーターを関数 fun(x) へ渡す方法を説明します。

例

x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub) は、解が常に lb ≤ x ≤ ub の範囲に存在するように、設計変数 x に上限と下限を定義します。lb(i) = ub(i) を指定することによって解の要素 x(i) を修正できます。

メモ

問題の指定された入力範囲が矛盾する場合、出力 x は x0、出力 resnorm と residual は [] です。

範囲 lb ≤ x ≤ ub に違反する x0 の要素は範囲で定義されたボックスの内部にリセットされます。範囲内の要素は変更されません。

例

x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub,A,b,Aeq,beq) は、線形制約を満たすように解を制約します。

A x ≤ b

Aeq x = beq.

例

x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub,A,b,Aeq,beq,nonlcon) は、nonlcon(x) 関数の非線形制約を満たすように解を制約します。nonlcon は 2 つの出力 ineqnonlin と eqnonlin を返します。ソルバーは制約を満たそうとします。

ineqnonlin ≤ 0

eqnonlin = 0.

例

x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub,options) または x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub,A,b,Aeq,beq,nonlcon,options) は、options で指定された最適化オプションを使って最小化します。optimoptions を使用してこれらのオプションを設定してください。引数が存在しない場合、lb と ub、および他の入力引数に空行列を渡してください。

例

x = lsqcurvefit(problem) は、problem で説明されている構造体 problem の最小値を求めます。

[x,resnorm] = lsqcurvefit(___) は、すべての入力引数に対して、x での残差の 2 乗ノルム値 (sum((fun(x,xdata)-ydata).^2)) を返します。

[x,resnorm,residual,exitflag,output] = lsqcurvefit(___) は上記に加え、解 x における残差の値 fun(x,xdata)-ydata、終了条件を記述する値 exitflag、および最適化プロセスに関する情報を含む構造体 output を返します。

例

[x,resnorm,residual,exitflag,output,lambda,jacobian] = lsqcurvefit(___) は上記に加え、解 x におけるラグランジュ乗数をフィールドに含む構造体 lambda、および解 x における fun のヤコビアンを返します。

例

すべて折りたたむ

観測時間データ xdata および観測応答データ ydata について、次の形式のモデルが適合するパラメーター x(1) および x(2) を求めるものとします。

ydata=x(1)exp(x(2)xdata).

観測時間と応答を入力します。

xdata = ...
 [0.9 1.5 13.8 19.8 24.1 28.2 35.2 60.3 74.6 81.3];
ydata = ...
 [455.2 428.6 124.1 67.3 43.2 28.1 13.1 -0.4 -1.3 -1.5];

単純な指数減衰モデルを作成します。

fun = @(x,xdata)x(1)*exp(x(2)*xdata);

開始点 x0 = [100,-1] を使用してモデルを当てはめます。

x0 = [100,-1];
x = lsqcurvefit(fun,x0,xdata,ydata)
Local minimum possible.

lsqcurvefit stopped because the final change in the sum of squares relative to 
its initial value is less than the value of the function tolerance.

<stopping criteria details>
x = 1×2

  498.8309   -0.1013

データと当てはめた曲線をプロットします。

times = linspace(xdata(1),xdata(end));
plot(xdata,ydata,"ko",times,fun(x,times),"b-")
legend("Data","Fitted exponential")
title("Data and Fitted Curve")
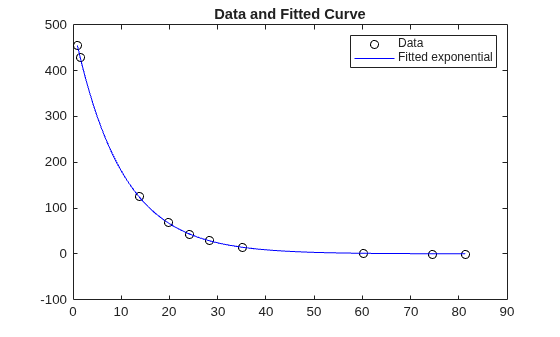
Data points and fitted exponential curve showing a good fit to exponentially decaying data

適合パラメーターに制約がある場合の、データへの最適な指数適合を求めます。

ノイズを含む指数減衰モデルからデータを生成します。モデルは次のとおりです。

y=exp(-1.3t)+ε,

ここで、t の範囲は 0 ~ 3、ε は平均が 0、標準偏差が 0.05 の正規分布ノイズです。

rng default % for reproducibility
xdata = linspace(0,3);
ydata = exp(-1.3*xdata) + 0.05*randn(size(xdata));

問題は、データ (xdata, ydata) について、データに最も適合する指数減衰モデル y=x(1)exp(x(2)xdata) の検出です。パラメーターには以下の境界があります。

0≤x(1)≤3/4

-2≤x(2)≤-1.

lb = [0,-2];
ub = [3/4,-1];

モデルを作成します。

fun = @(x,xdata)x(1)*exp(x(2)*xdata);

初期推定を作成します。

x0 = [1/2,-2];

有界適合問題を解きます。

x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub)
Local minimum found.

Optimization completed because the size of the gradient is less than
the value of the optimality tolerance.

<stopping criteria details>
x = 1×2

    0.7500   -1.0000

生成された曲線がどれだけ適切にデータに合っているかを検証します。制約によって解と実際の値に差が生じるため、この近似は最適なものではありません。

plot(xdata,ydata,"ko",xdata,fun(x,xdata),"b-")
legend("Data","Fitted exponential")
title("Data and Fitted Curve")
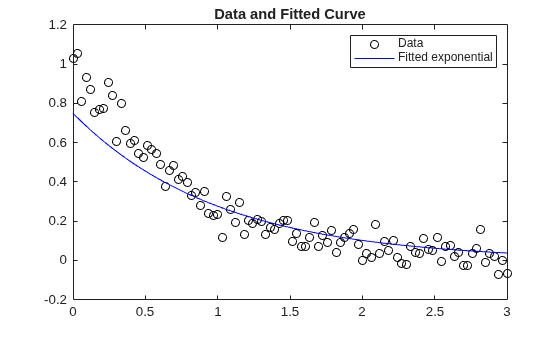
Noisy exponential decay data with fitted exponential curve using bound constraints

パラメーター a、b、t0、および c を使用して、非線形モデル y=a+barctan(t-t0)+ct 用に、時間 t が 2 ~ 7 の人為的なデータを作成します。randn を使用してデータにノイズを追加します。

a = 2; % x(1)
b = 4; % x(2)
t0 = 5; % x(3)
c = 1/2; % x(4)
xdata = linspace(2,7);
rng default
ydata = a + b*atan(xdata - t0) + c*xdata + 1/10*randn(size(xdata));

データをプロットします。

plot(xdata,ydata,"ro")
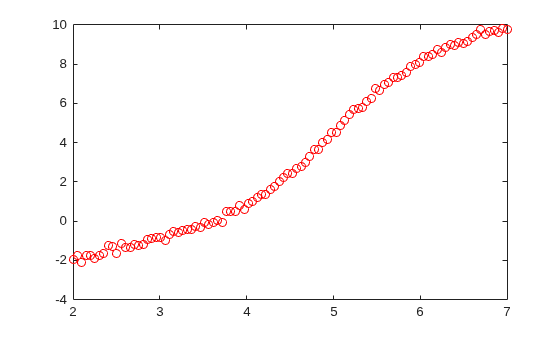
Scatter plot of noisy data points following a nonlinear trend from about -2 to 10 over the range t = 2 to 7

次の制約に従い、非線形モデルをデータに当てはめます。

  • 係数はすべて 0 ~ 7 の間。

  • x1+x2≥x3+x4.この制約を、A = [-1 -1 1 1] と b = 0 を使用して A*x <= b の形式で記述できる。

lb = zeros(4,1);
ub = 7*ones(4,1);
A = [-1 -1 1 1];
b = 0;

この例の最後に記載されている関数 myfun が、このモデルの目的関数を作成します。

点 [1 2 3 1] から始めて近似問題を解きます。

startpt = [1 2 3 1];
Aeq = [];
beq = [];
[x,res] = lsqcurvefit(@myfun,startpt,xdata,ydata,lb,ub,A,b,Aeq,beq)
Local minimum found that satisfies the constraints.

Optimization completed because the objective function is non-decreasing in 
feasible directions, to within the value of the optimality tolerance,
and constraints are satisfied to within the value of the constraint tolerance.

<stopping criteria details>
x = 1×4

    2.3447    4.0972    4.9979    0.4303

res = 
1.2682

返された解は、元の点 [2 4 5 1/2] からそれほど離れていません。解点からの曲線に対してデータをプロットします。

plot(xdata,ydata,"ro",xdata,myfun(x,xdata),"b-")
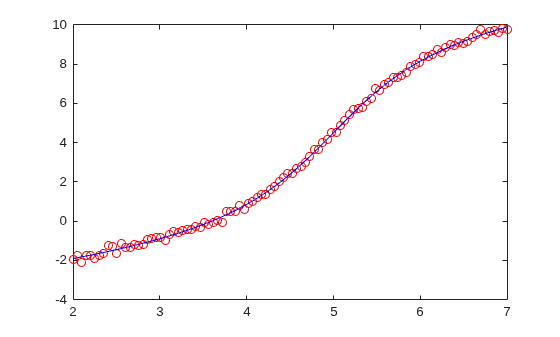
Data points (red circles) and fitted curve (blue line) showing the nonlinear model closely matching the data

返された解は、データとかなり一致しています。制約はアクティブでしょうか。

A*x(:)
ans = 
-1.0137

A*x < 0 のため、制約はアクティブではありません。

function F = myfun(x,xdata)
a = x(1);
b = x(2);
t0 = x(3);
c = x(4);
F = a + b*atan(xdata - t0) + c*xdata;
end

パラメーター a、b、t0、および c を使用して、非線形モデル y=a+barctan(t-t0)+ct 用に、時間 t が 2 ~ 7 の人為的なデータを作成します。randn を使用してデータにノイズを追加します。

a = 2; % x(1)
b = 4; % x(2)
t0 = 5; % x(3)
c = 1/2; % x(4)
xdata = linspace(2,7);
rng default
ydata = a + b*atan(xdata - t0) + c*xdata + 1/10*randn(size(xdata));

データをプロットします。

plot(xdata,ydata,"o")
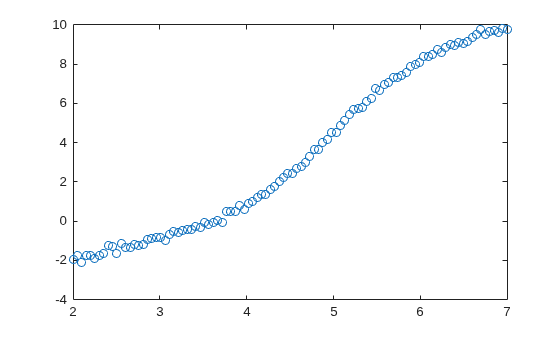
Scatter plot of noisy data points following a nonlinear trend from about -2 to 10 over the range t = 2 to 7

次の制約に従い、非線形モデルをデータに当てはめます。

  • 係数はすべて 0 ~ 7 の間。

  • x12+x22≤42

lb = zeros(4,1);
ub = 7*ones(4,1);

この問題には、線形制約がありません。

A = [];
b = [];
Aeq = [];
beq = [];

myfun 関数は、このモデルの目的関数を作成します。

function F = myfun(x,xdata)
a = x(1);
b = x(2);
t0 = x(3);
c = x(4);
F = a + b*atan(xdata - t0) + c*xdata;
end

nlcon 関数は、非線形制約関数を作成します。

function [ineqnonlin,eqnonlin] = nlcon(x)
eqnonlin = [];
ineqnonlin = x(1)^2 + x(2)^2 - 4^2;
end

点 [1 2 3 1] から始めて近似問題を解きます。

startpt = [1 2 3 1];
[x,res] = lsqcurvefit(@myfun,startpt,xdata,ydata,lb,ub,A,b,Aeq,beq,@nlcon)
Feasible point with lower objective function value found, but optimality criteria not satisfied. See output.bestfeasible..


Local minimum found that satisfies the constraints.

Optimization completed because the objective function is non-decreasing in 
feasible directions, to within the value of the optimality tolerance,
and constraints are satisfied to within the value of the constraint tolerance.

<stopping criteria details>
x = 1×4

    1.3806    3.7542    5.0169    0.6337

res = 
1.6018

返された解 x は、元の点 [2 4 5 1/2] で非線形制約に違反しているため、そこにはありません。解点からの曲線に対してデータをプロットし、制約関数を計算します。

plot(xdata,ydata,"o",xdata,myfun(x,xdata),"-")
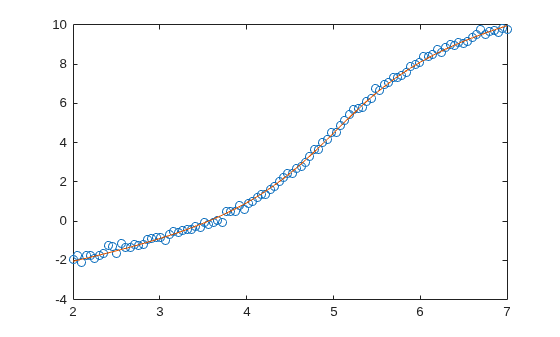
Data points (blue circles) and fitted curve (red line) showing the constrained nonlinear model closely matching the data

[ineqnonlin,eqnonlin] = nlcon(x)
ineqnonlin = 
-3.1307e-06
eqnonlin =

     []

この解において ineqnonlin = 0 であるため、非線形不等式制約はこの解においてアクティブです。

解点が元の点にないにもかかわらず、解の曲線はデータとかなり一致しています。

既定の "trust-region-reflective" アルゴリズムと "levenberg-marquardt" アルゴリズムによる適合の結果を比較します。

観測時間データ xdata および観測応答データ ydata について、次の形式のモデルが適合するパラメーター x(1) および x(2) を求めるものとします。

ydata=x(1)exp(x(2)xdata).

観測時間と応答を入力します。

xdata = ...
 [0.9 1.5 13.8 19.8 24.1 28.2 35.2 60.3 74.6 81.3];
ydata = ...
 [455.2 428.6 124.1 67.3 43.2 28.1 13.1 -0.4 -1.3 -1.5];

単純な指数減衰モデルを作成します。

fun = @(x,xdata)x(1)*exp(x(2)*xdata);

開始点 x0 = [100,-1] を使用してモデルを当てはめます。

x0 = [100,-1];
x = lsqcurvefit(fun,x0,xdata,ydata)
Local minimum possible.

lsqcurvefit stopped because the final change in the sum of squares relative to 
its initial value is less than the value of the function tolerance.

<stopping criteria details>
x = 1×2

  498.8309   -0.1013

この解を "levenberg-marquardt" による近似と比較します。

options = optimoptions("lsqcurvefit",Algorithm="levenberg-marquardt");
lb = [];
ub = [];
x = lsqcurvefit(fun,x0,xdata,ydata,lb,ub,options)
Local minimum possible.
lsqcurvefit stopped because the relative size of the current step is less than
the value of the step size tolerance.

<stopping criteria details>
x = 1×2

  498.8309   -0.1013

2 つのアルゴリズムが同じ解に収束しています。データと当てはめた指数モデルをプロットします。

times = linspace(xdata(1),xdata(end));
plot(xdata,ydata,"ko",times,fun(x,times),"b-")
legend("Data","Fitted exponential")
title("Data and Fitted Curve")
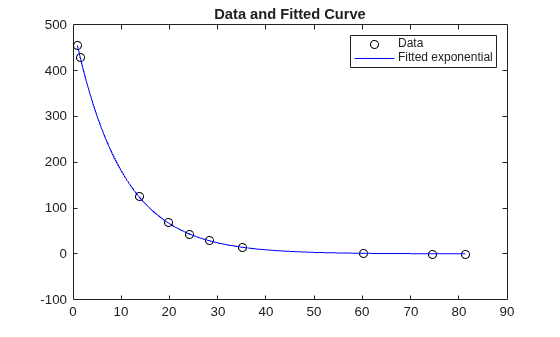
Data points and fitted exponential decay curve showing a good fit to the observations

既定の "trust-region-reflective" アルゴリズムと "levenberg-marquardt" アルゴリズムによる適合の結果を比較します。解法プロセスを検証して、この場合にどちらがより効率的かを確認します。

観測時間データ xdata および観測応答データ ydata について、次の形式のモデルが適合するパラメーター x(1) および x(2) を求めるものとします。

ydata=x(1)exp(x(2)xdata).

観測時間と応答を入力します。

xdata = ...
 [0.9 1.5 13.8 19.8 24.1 28.2 35.2 60.3 74.6 81.3];
ydata = ...
 [455.2 428.6 124.1 67.3 43.2 28.1 13.1 -0.4 -1.3 -1.5];

単純な指数減衰モデルを作成します。

fun = @(x,xdata)x(1)*exp(x(2)*xdata);

開始点 x0 = [100,-1] を使用してモデルを当てはめます。

x0 = [100,-1];
[x,resnorm,residual,exitflag,output] = lsqcurvefit(fun,x0,xdata,ydata);
Local minimum possible.

lsqcurvefit stopped because the final change in the sum of squares relative to 
its initial value is less than the value of the function tolerance.

<stopping criteria details>

この解を "levenberg-marquardt" による近似と比較します。

options = optimoptions("lsqcurvefit",Algorithm="levenberg-marquardt");
lb = [];
ub = [];
[x2,resnorm2,residual2,exitflag2,output2] = lsqcurvefit(fun,x0,xdata,ydata,lb,ub,options);
Local minimum possible.
lsqcurvefit stopped because the relative size of the current step is less than
the value of the step size tolerance.

<stopping criteria details>

これらの解は等価でしょうか。

norm(x-x2)
ans = 
2.0654e-06

これらの解は等価です。

解が得られるまでの関数評価の回数が少ないのは、どちらのアルゴリズムでしょうか。

fprintf(['The ''trust-region-reflective'' algorithm took %d function evaluations,\n',...
   'and the ''levenberg-marquardt'' algorithm took %d function evaluations.\n'],...
   output.funcCount,output2.funcCount)
The 'trust-region-reflective' algorithm took 87 function evaluations,
and the 'levenberg-marquardt' algorithm took 72 function evaluations.

データと当てはめた指数モデルをプロットします。

times = linspace(xdata(1),xdata(end));
plot(xdata,ydata,"ko",times,fun(x,times),"b-")
legend("Data","Fitted exponential")
title("Data and Fitted Curve")
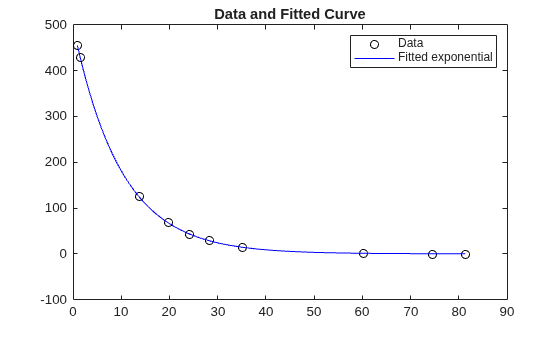
Data points and fitted exponential decay curve showing a good fit to the observations

適切に近似されているように見えます。残差の大きさはどの程度でしょうか。

fprintf(['The ''trust-region-reflective'' algorithm has residual norm %f,\n',...
   'and the ''levenberg-marquardt'' algorithm has residual norm %f.\n'],...
   resnorm,resnorm2)
The 'trust-region-reflective' algorithm has residual norm 9.504887,
and the 'levenberg-marquardt' algorithm has residual norm 9.504887.

入力引数

すべて折りたたむ

当てはめる関数。関数ハンドルまたは関数名として指定されます。"interior-point" アルゴリズムの場合、fun は関数ハンドルである必要があります。fun は 2 つの入力、ベクトルまたは行列 x とベクトルまたは行列 xdata を取る関数です。fun はベクトルまたは行列 F を返しますが、これは x と xdata で評価される目的関数です。

メモ

fun は二乗和 sum((fun(x,xdata)-ydata).^2) ではなく、fun(x,xdata) を返します。lsqcurvefit は fun(x,xdata)-ydata の要素の二乗和を暗黙的に計算します。例を参照してください。

関数 fun は関数ファイルの関数ハンドルとして指定することができます。

x = lsqcurvefit(@myfun,x0,xdata,ydata)

ここで myfun は次のような MATLAB® 関数です。

function F = myfun(x,xdata)
F = ...     % Compute function values at x, xdata

fun は無名関数の関数ハンドルにもなります。

f = @(x,xdata)x(1)*xdata.^2+x(2)*sin(xdata);
x = lsqcurvefit(f,x0,xdata,ydata);

lsqcurvefit は、x0 引数の形式で x を目的関数に渡します。たとえば、x0 が 5 行 3 列の配列の場合、lsqcurvefit は 5 行 3 列の配列として x を fun に渡します。

ヤコビアンも計算することができ、さらに下式で設定された SpecifyObjectiveGradient オプションが true である場合を考えます。

options = optimoptions("lsqcurvefit",SpecifyObjectiveGradient=true)

関数 fun は 2 番目の出力引数に x でのヤコビ値 J (行列) を返さなければなりません。nargout の値を確認することで、1 つの出力引数のみの場合 (最適化アルゴリズムが J ではなく F の値のみを必要とする場合)、fun が呼び出されるときに J の演算を避けることができます。

function [F,J] = myfun(x,xdata)
F = ...          % objective function values at x
if nargout > 1   % two output arguments
   J = ...   % Jacobian of the function evaluated at x
end

fun が m 個の要素をもつベクトル (行列) を返し、x が n 個の要素をもつ場合 (ここで、n は x0 の要素数)、ヤコビアン J は m 行 n 列の行列になります。ここで、J(i,j) は F(i) の x(j) に関する偏導関数です。(ヤコビアン J は、F の勾配の転置であることに注意してください。)詳細については、ベクトルと行列の目的関数の記述を参照してください。

例: @(x,xdata)x(1)*exp(-x(2)*xdata)

データ型: char | function_handle | string

初期点。実数ベクトルまたは実数配列として指定されます。ソルバーは、x0 の要素数および x0 のサイズを使用して、fun が受け入れる変数の数およびサイズを決定します。

例: x0 = [1,2,3,4]

データ型: double

モデルの入力データ。実数ベクトルまたは実数配列として指定されます。モデルは次のとおりです。

ydata = fun(x,xdata),

ここで、xdata および ydata は固定配列、x は二乗和の最小値の探索のために lsqcurvefit によって変更されるパラメーターの配列です。

例: xdata = [1,2,3,4]

データ型: double

モデルの応答データ。実数ベクトルまたは実数配列として指定されます。モデルは次のとおりです。

ydata = fun(x,xdata),

ここで、xdata および ydata は固定配列、x は二乗和の最小値の探索のために lsqcurvefit によって変更されるパラメーターの配列です。

ydata 配列のサイズおよび形状は、配列 fun(x0,xdata) と同じでなければなりません。

例: ydata = [1,2,3,4]

データ型: double

下限。実数ベクトルまたは実数配列として指定されます。x0 の要素数と lb の要素数が等しい場合、lb は次を指定します。

x(i) &gt;= lb(i) (すべての i について)(1)

numel(lb) < numel(x0) の場合、lb は次を指定します。

x(i) &gt;= lb(i) (1 <= i <= numel(lb))(2)

lb の要素数が x0 より少ない場合、ソルバーは警告を生成します。

例: x のすべての成分が正であることを指定するには、lb = zeros(size(x0)) を使用します。

データ型: double

実数ベクトルまたは実数配列として指定される上限です。x0 の要素数と ub の要素数が等しい場合、ub は次を指定します。

x(i) <= ub(i) (すべての i について)(3)

numel(ub) < numel(x0) の場合、ub は次を指定します。

x(i) <= ub(i) (1 <= i <= numel(ub))(4)

ub の要素数が x0 より少ない場合、ソルバーは警告を生成します。

例: x のすべての成分が 1 未満であることを指定するには、ub = ones(size(x0)) を使用します。

データ型: double

実数行列として指定される線形不等式制約です。A は M 行 N 列の行列で、M は不等式の数、N は変数の数 (x0 の要素数) です。スパース データをサポートするアルゴリズムを使用する大規模な問題の場合は、A をスパース行列として渡します。最適化アルゴリズムのスパース性を参照してください。

A は M 個の線形不等式を符号化します。

A*x <= b,(5)

ここで、x は N 個の変数 x(:) の列ベクトル、b は M 個の要素をもつ列ベクトルです。

たとえば、次の不等式を考えてみましょう。

x1 + 2x2 ≤ 10
3x1 + 4x2 ≤ 20
5x1 + 6x2 ≤ 30
(6)

次の制約を入力することによって、不等式を指定します。

A = [1,2;3,4;5,6];
b = [10;20;30];

例: x の成分の和が 1 以下であることを指定するには、A = ones(1,N) と b = 1 を使用します。

データ型: double

実数ベクトルで指定される線形不等式制約です。b は、行列 A に関連する M 要素ベクトルです。b を行ベクトルとして渡す場合、ソルバーは b を列ベクトル b(:) に内部的に変換します。

b は M 個の線形不等式を符号化します。

A*x <= b,(7)

ここで、x は N 個の変数 x(:) の列ベクトル、A は M 行 N 列の行列です。

たとえば、次の不等式を考えてみましょう。

x1 + 2x2 ≤ 10
3x1 + 4x2 ≤ 20
5x1 + 6x2 ≤ 30
(8)

次の制約を入力することによって、不等式を指定します。

A = [1,2;3,4;5,6];
b = [10;20;30];

例: x の成分の和が 1 以下であることを指定するには、A = ones(1,N) と b = 1 を使用します。

データ型: double

実数行列として指定される線形等式制約です。Aeq は Me 行 N 列の行列で、Me は等式の数、N は変数の数 (x0 の要素数) です。スパース データをサポートするアルゴリズムを使用する大規模な問題の場合は、A をスパース行列として渡します。最適化アルゴリズムのスパース性を参照してください。

Aeq は Me 個の線形等式を符号化します。

Aeq*x = beq,(9)

ここで、x は N 個の変数 x(:) の列ベクトル、beq は Me 個の要素をもつ列ベクトルです。

たとえば、次の不等式を考えてみましょう。

x1 + 2x2 + 3x3 = 10
2x1 + 4x2 + x3 = 20
(10)

次の制約を入力することによって、不等式を指定します。

Aeq = [1,2,3;2,4,1];
beq = [10;20];

例: x の成分の和が 1 であることを指定するには、Aeq = ones(1,N) と beq = 1 を使用します。

データ型: double

実数ベクトルで指定される線形等式制約です。beq は、行列 Aeq に関連する Me 要素ベクトルです。beq を行ベクトルとして渡す場合、ソルバーはこれを列ベクトル beq(:) に内部的に変換します。

beq は Me 個の線形等式を符号化します。

Aeq*x = beq,(11)

ここで、x は N 個の変数 x(:) の列ベクトル、Aeq は Me 行 N 列の行列です。

たとえば、次の等式を考えてみましょう。

x1 + 2x2 + 3x3 = 10
2x1 + 4x2 + x3 = 20
(12)

次の制約を入力することによって、等式を指定します。

Aeq = [1,2,3;2,4,1];
beq = [10;20];

例: x の成分の和が 1 であることを指定するには、Aeq = ones(1,N) と beq = 1 を使用します。

データ型: double

非線形制約。関数ハンドルとして指定されます。nonlcon は、ベクトルまたは配列 x を受け、2 つの配列 ineqnonlin(x) および eqnonlin(x) を返す関数です。

  • ineqnonlin(x) は、x での非線形不等式制約の配列です。lsqcurvefit は次の条件を満たそうとします。

    ineqnonlin のすべてのエントリに対して ineqnonlin(x) <= 0。(13)
  • eqnonlin(x) は、x での非線形等式制約の配列です。lsqcurvefit は次の条件を満たそうとします。

    eqnonlin のすべてのエントリに対して eqnonlin(x) = 0。(14)

以下に例を示します。

x = lsqcurvefit(@myfun,x0,xdata,ydata,lb,ub,A,b,Aeq,beq,@mycon,options)

ここで mycon は次のような MATLAB 関数です。

function [ineqnonlin,eqnonlin] = mycon(x)
ineqnonlin = ...     % Compute nonlinear inequalities at x.
eqnonlin = ...   % Compute nonlinear equalities at x.
また制約関数の勾配を計算することができ、"さらに" 次のように SpecifyConstraintGradient オプションが true である場合、
options = optimoptions("lsqcurvefit",SpecifyConstraintGradient=true)
nonlcon は 3 番目および 4 番目の出力引数に ineqnonlin(x) の勾配 GC および eqnonlin(x) の勾配 GCeq を返さなければなりません。GC と GCeq はスパースか密である可能性があります。GC か GCeq が大きく、非ゼロの項目が比較的少ない場合は、それらをスパース行列として使用して、"interior-point" アルゴリズム内の実行時間とメモリを節約します。詳細については、非線形制約を参照してください。

データ型: function_handle

最適化オプション。optimoptions の出力、または optimset などによって返される構造体として指定されます。

いくつかのオプションはすべてのアルゴリズムに適用することができ、その他のオプションは特定のアルゴリズムに関連します。詳細については、最適化オプション リファレンスを参照してください。

一部のオプションは、optimoptions に表示されません。このようなオプションは、次の表ではイタリックで示されています。詳細については、最適化オプションの表示を参照してください。

すべてのアルゴリズム

Algorithm

"trust-region-reflective" (既定の設定)、"levenberg-marquardt"、"interior-point" から選択します。

Algorithm オプションは使用するアルゴリズムの優先順位を指定します。これは基本設定のみです。条件によっては、各アルゴリズムに対応しなければならないからです。信頼領域 Reflective 法アルゴリズムでは、fun によって返される F の要素数は少なくとも x の長さと同じでなければなりません。

"interior-point" アルゴリズムは、線形制約または非線形制約がある問題を解決できる唯一のアルゴリズムです。これらの制約を問題に含め、アルゴリズムを指定していない場合、ソルバーは自動的に "interior-point" アルゴリズムに切り替わります。"interior-point" アルゴリズムは、fmincon の "interior-point" アルゴリズムの変更されたバージョンを呼び出します。

アルゴリズムの選択の詳細については、アルゴリズムの選択を参照してください。

Diagnostics

最小化または計算する関数に関する情報を表示します。選択肢は、"off" (既定の設定) または "on" です。

DiffMaxChange

有限差分勾配を計算する場合に変数内で生じる最大変化量です (正のスカラー)。既定値は Inf です。

DiffMinChange

有限差分勾配を計算する場合に変数内で生じる最小変化量です (正のスカラー)。既定値は 0 です。

Display

表示レベル (反復表示を参照):

  • "off" または "none" — 出力を表示しない。

  • "iter" — 各反復の出力を表示し、既定の終了メッセージを与える。

  • "iter-detailed" — 各反復の出力を表示し、技術的な終了メッセージを与える。

  • "final" (既定の設定) — 最終出力を表示し、既定の終了メッセージを返す。

  • "final-detailed" — 最終出力のみを表示し、技術的な終了メッセージを与える。

FiniteDifferenceStepSize

有限差分のスカラーまたはベクトルのステップ サイズ ファクター。FiniteDifferenceStepSize をベクトル v に設定すると、前方有限差分 delta は次のようになります。

delta = v.*sign′(x).*max(abs(x),TypicalX);

ここで、sign′(0) = 1 を除き sign′(x) = sign(x) です。中心有限差分は次のようになります。

delta = v.*max(abs(x),TypicalX);

スカラー FiniteDifferenceStepSize はベクトルに展開されます。既定値は、前進有限差分法では sqrt(eps)、中心有限差分法では eps^(1/3) です。

optimset の場合、名前は FinDiffRelStep です。新旧のオプション名を参照してください。

FiniteDifferenceType

勾配推定に使用される有限差分は "forward" (既定の設定) または "central" (中心) のいずれかです。"central" では 2 倍の関数評価が必要になりますが、正確性が増します。

アルゴリズムは有限差分の両方のタイプを推定するとき、範囲に注意深く従います。そのためたとえば、forward ではなく、backward を選択すると、範囲外の点を計算しないようにすることができます。

optimset の場合、名前は FinDiffType です。新旧のオプション名を参照してください。

FunctionTolerance

関数値に関する終了許容誤差 (非負のスカラー)。既定値は 1e-6 です。許容誤差と停止条件を参照してください。

optimset の場合、名前は TolFun です。新旧のオプション名を参照してください。

FunValCheck

関数値が有効かどうかをチェックします。"on" は、関数が complex、Inf、または NaN である値を返すと、エラーを表示します。既定の "off" ではエラーを表示しません。

MaxFunctionEvaluations

関数評価の最大許容回数 (非負の整数)。既定の値は "trust-region-reflective" アルゴリズムでは 100*numberOfVariables、"levenberg-marquardt" アルゴリズムでは 200*numberOfVariables、"interior-point" アルゴリズムでは 3000 です。詳細については、許容誤差と停止条件および反復と関数カウントを参照してください。

optimset の場合、名前は MaxFunEvals です。新旧のオプション名を参照してください。

MaxIterations

反復の最大許容回数 (非負の整数)。既定の値は、"trust-region-reflective" および "levenberg-marquardt" アルゴリズムでは 400、"interior-point" アルゴリズムでは 1000 です。詳細については、許容誤差と停止条件および反復と関数カウントを参照してください。

optimset の場合、名前は MaxIter です。新旧のオプション名を参照してください。

OptimalityTolerance

1 次の最適性に関する終了許容誤差 (非負のスカラー)。既定値は 1e-6 です。1 次の最適性の尺度を参照してください。

内部的に、"levenberg-marquardt" アルゴリズムは、FunctionTolerance の 1e-4 倍となる最適性の許容誤差 (停止条件) を使用し、OptimalityTolerance は使用しません。

optimset の場合、名前は TolFun です。新旧のオプション名を参照してください。

OutputFcn

各反復で最適化関数が呼び出すユーザー定義の関数を 1 つ以上指定します。関数ハンドルか、関数ハンドルの cell 配列を渡します。既定の設定はなし ([]) です。出力関数とプロット関数の構文を参照してください。

PlotFcn

アルゴリズムが実行中のさまざまな進行状況の測定値をプロットします。事前定義されたプロットから選択するか、独自のコードを記述してください。名前、関数ハンドル、または名前か関数ハンドルの cell 配列を渡します。カスタム プロット関数の場合は、関数ハンドルを渡します。既定の設定はなし ([]) です。

  • "optimplotx" は現在の点をプロットします。

  • "optimplotfunccount" は関数カウントをプロットします。

  • "optimplotfval" は関数値をプロットします。

  • "optimplotresnorm" は残差のノルムをプロットします。

  • "optimplotstepsize" はステップ サイズをプロットします。

  • "optimplotfirstorderopt" は 1 次の最適性尺度をプロットします。

カスタムのプロット関数は、出力関数と同じ構文を使用します。詳細については、Optimization Toolbox の出力関数および出力関数とプロット関数の構文を参照してください。

optimset の場合、名前は PlotFcns です。新旧のオプション名を参照してください。

SpecifyObjectiveGradient

false (既定の設定) の場合、ソルバーは有限差分法を使用してヤコビアンを近似します。true の場合、ソルバーは目的関数に対してユーザー定義のヤコビアン (既定の設定では fun)、または (JacobMult を使用するときの) ヤコビ情報を使用します。

optimset の場合、名前は Jacobian で、値は "on" または "off" です。新旧のオプション名を参照してください。

StepTolerance

x に関する終了許容誤差 (非負のスカラー)。既定の値は、"trust-region-reflective" および "levenberg-marquardt" アルゴリズムでは 1e-6、"interior-point" アルゴリズムでは 1e-10 です。許容誤差と停止条件を参照してください。

optimset の場合、名前は TolX です。新旧のオプション名を参照してください。

TypicalX

典型的な x の値です。TypicalX の要素数は、開始点 x0 の要素数と等しくなります。既定値は ones(numberofvariables,1) です。ソルバーは TypicalX を使用して勾配推定の有限差分をスケーリングします。

UseParallel

勾配の推定に並列計算を使用するためのオプション。次の値のいずれかとして指定します。

  • "auto" — 並列プールが開いているか、プールの自動作成が有効になっていれば、並列で勾配を推定します。それ以外の場合、逐次的に勾配を推定します。

  • "on" — 並列で勾配を推定します。開いている並列プールがない場合は、既定のクラスター プロファイルを使用してソルバーによって起動されます。

  • "off" (既定の設定) — 逐次的に勾配を推定します。

下位互換性のため、値 true と false も受け入れられます。これらの値は "auto" と "off" にそれぞれ対応します。

MATLAB で並列プールを使用して計算を実行するには、Parallel Computing Toolbox™ が必要です。

詳細については、並列計算を参照してください。

信頼領域 Reflective 法アルゴリズム
JacobianMultiplyFcn

ヤコビ乗算関数。関数ハンドルとして指定されます。大規模構造化問題に対して、この関数は実際に J を計算しないで、ヤコビ行列乗算 J*Y、J'*Y、J'*(J*Y) のいずれかを計算します。lsqnonlin の場合、この関数は次の形式を取ります。

W = jmfun(Jinfo,Y,flag)

ここで、Jinfo は J*Y (または J'*Y か J'*(J*Y)) の計算に役立つデータを含んでいます。lsqcurvefit の場合、この関数は次の形式を取ります。

W = jmfun(Jinfo,Y,flag,xdata)

ここで、xdata は xdata 引数に渡されるデータです。

データ Jinfo は目的関数 fun で返される 2 番目の引数です。

[F,Jinfo] = fun(x)
% or [F,Jinfo] = fun(x,xdata)

lsqcurvefit はデータ Jinfo、Y、flag、および lsqcurvefit の場合は xdata を渡し、関数 jmfun は次に示すように結果を計算します。Y は、サイズが flag の値によって決まる行列です。m は目的関数 fun の要素数を指定し、n は x 内の問題変数の個数を指定するとします。ヤコビアンのサイズは、fun で説明されているように m 行 n 列です。関数 jmfun は次のいずれかの結果を返します。

  • flag == 0 の場合、W = J'*(J*Y) で、Y のサイズは n 行 2 列です。

  • flag > 0 の場合、W = J*Y で、Y のサイズは n 行 1 列です。

  • flag < 0 の場合、W = J'*Y で、Y のサイズは m 行 1 列です。

どの場合でも、J は明示的に形成されません。ソルバーは Jinfo を使用して乗算を計算します。jmfun が必要とする追加のパラメーターを与える方法については 追加パラメーターの受け渡し を参照してください。

メモ

SpecifyObjectiveGradient は true に設定し、ソルバーが Jinfo を fun から jmfun に渡すようにしなければなりません。

同様の例は 密に構造化されたヘッシアンと線形等式を使用した最小化 と 線形最小二乗付きヤコビ乗算関数 を参照してください。

optimset の場合、名前は JacobMult です。新旧のオプション名を参照してください。

JacobPattern

有限差分に対するヤコビ スパース パターン。fun(i) が x(j) によって異なる場合、JacobPattern(i,j) = 1 を設定します。それ以外の場合は、JacobPattern(i,j) = 0 を設定します。言い換えると、∂fun(i)/∂x(j) ≠ 0 をもつことができる場合、JacobPattern(i,j) = 1 となります。

fun でヤコビ行列 J を計算するのが不便な場合は、JacobPattern を使用します。ただし、fun(i) が x(j) によって異なる場合は見ただけで判断できます。JacobPattern を提供できる場合、ソルバーはスパース有限差分を使って J を近似することができます。

構造が不明であれば、JacobPattern を設定しないでください。既定では、JacobPattern は 1 からなる密行列のように動作します。その後、ソルバーは、非スパース状態の有限差分近似を反復ごとに計算します。大規模な問題では、この計算には多大なリソースが必要となる場合があり、通常はスパース構造を決定するのが妥当です。

MaxPCGIter

PCG (前処理付き共役勾配) 法の反復の最大回数です (正のスカラー)。既定値は max(1,numberOfVariables/2) です。詳細については、大規模な非線形最小二乗法を参照してください。

PrecondBandWidth

PCG に対する前提条件子の帯域幅の上限 (非負の整数)。既定の PrecondBandWidth が Inf の場合、共役勾配 (CG) ではなく、直接因子分解 (コレスキー因子) が使用されます。直接因子分解では CG より計算量が増加しますが、解を求めるためのステップの質が向上します。対角型をした前提条件のために、PrecondBandWidth を 0 に設定します (上部帯域幅 0)。一部の問題では帯域幅を中間にすることで PCG 法の反復回数を減らします。

SubproblemAlgorithm

反復ステップの計算方法を定義します。既定の設定である "factorization" のステップは "cg" より低速ですが、精度の点で勝ります。信頼領域 Reflective 法の最小二乗を参照してください。

TolPCG

PCG 反復に関する終了許容誤差 (正のスカラー)。既定値は 0.1 です。

レーベンバーグ・マルカート法アルゴリズム
InitDamping

レーベンバーグ・マルカート パラメーターの初期値 (正のスカラー)。既定値は 1e-2 です。詳細については、レーベンバーグ・マルカート法を参照してください。

ScaleProblem

"jacobian" は、適切にスケール化されていない問題に対して収束性を高める場合があります。既定値は "none" です。

UseCodegenSolver

ターゲット ハードウェアで実行されているバージョンのソフトウェアを使用するための指定。true または false (既定の設定) として指定します。このオプションを使用すると、コードを生成する前またはコードをハードウェアに展開する前に、ソルバーの動作を確認できます。コード生成時にこのオプションを含めることができます。このオプションはコード生成には影響しませんが、オプションを含めたままにしておくと、削除する手間が省けます。生成されるコードは MATLAB コードと同じですが、リンクされている数学ライブラリが異なる可能性があるため、結果は若干異なる場合があります。

内点法アルゴリズム
BarrierParamUpdate

fmincon による範囲パラメーターの更新方法を指定します (fmincon の内点法アルゴリズムを参照)。以下のオプションがあります。

  • "monotone" (既定の設定)

  • "predictor-corrector"

このオプションは、ソルバーの速度と収束性に影響が及びますが、その影響の予測は困難です。

ConstraintTolerance

制約違反に関する許容誤差 (非負のスカラー)。既定値は 1e-6 です。許容誤差と停止条件を参照してください。

optimset の場合、名前は TolCon です。新旧のオプション名を参照してください。

InitBarrierParam

初期境界値 (正のスカラー)。既定の 0.1 より大きい値を試すのに役立つ場合があります。特に、目的関数や制約関数が大きい場合役立ちます。

SpecifyConstraintGradient

ユーザーにより定義される非線形制約関数に対する勾配。既定の false に設定すると、lsqcurvefit は有限差分の非線形制約の勾配を推定します。nonlcon で説明するように、lsqcurvefit は、true に設定されると、制約関数が 4 つの出力をもつことを期待します。

optimset の場合、名前は GradConstr で、値は "on" または "off" です。新旧のオプション名を参照してください。

SubproblemAlgorithm

反復ステップの計算方法を定義します。"cg" は密なヘッシアンをもつ大規模な問題より高速に解ける可能性がありますが、既定の "factorization" は一般に "cg" (共役勾配) より高速になります。fmincon の内点法アルゴリズムを参照してください。

optimset の場合、値は "cg" および "ldl-factorization" です。新旧のオプション名を参照してください。

例: options = optimoptions("lsqcurvefit",FiniteDifferenceType="central")

次のフィールドをもつ構造体として指定される問題構造体です。

フィールド名エントリ

objective

目的関数

x0

x の初期点

xdata

目的関数の入力データ

ydata

目的関数に一致させる出力データ

Aineq

線形不等式制約の行列

bineq

線形不等式制約のベクトル

Aeq

線形等式制約の行列

beq

線形等式制約のベクトル
lb下限のベクトル
ub上限のベクトル

nonlcon

非線形制約関数

solver

"lsqcurvefit"

options

optimoptions で作成されたオプション

problem 構造体では、少なくとも objective、x0、solver、xdata、ydata、および options フィールドを指定しなければなりません。

データ型: struct

出力引数

すべて折りたたむ

実数ベクトルまたは実数配列として返される解です。x のサイズは、x0 のサイズと同じです。通常、exitflag が正の場合、x は問題に対する局所的な解になります。解の質の詳細については、ソルバーが成功する場合を参照してください。

残差の 2 乗ノルム。非負の実数として返されます。resnorm は、x における残差の二乗した 2 ノルム (sum((fun(x,xdata)-ydata).^2)) です。

解での目的関数の値。配列として返されます。一般的に、residual = fun(x,xdata)-ydata になります。

ソルバーの停止理由。整数として返されます。

1

関数が解 x に収束したことを示します。

2

x の変化が指定された許容誤差を下回っているか、x におけるヤコビアンが未定義です。

3

残差の変化が指定された許容誤差を下回っています。

4

探索方向の相対振幅がステップの許容誤差を下回っています。

0

反復回数が options.MaxIterations を超過、または関数評価の回数が options.MaxFunctionEvaluations を超過しています。

-1

プロット関数または出力関数がソルバーを停止させたことを示します。

-2

実行可能点が検出されませんでした。範囲 lb と ub が適切ではないか、ソルバーが実行不可能な点で停止しました。

最適化プロセスに関する情報。次のフィールドをもつ構造体として返されます。

firstorderopt

1 次の最適性の尺度

iterations

実行した反復回数

funcCount

関数評価回数です。

cgiterations

PCG 法での合計反復回数 ('trust-region-reflective' と 'interior-point' アルゴリズム)

stepsize

x の最終変位

constrviolation

制約関数の最大値 ('interior-point' アルゴリズム)

bestfeasible

検出された最適 (最小目的関数) 実行可能点 ('interior-point' アルゴリズム)。次のフィールドで構成される構造体:

  • x

  • fval

  • firstorderopt

  • constrviolation

実行可能点が見つからなかった場合は、bestfeasible フィールドが空になります。そのため、制約関数の最大値が options.ConstraintTolerance を超えなければ、点は実行可能になります。

bestfeasible の点は、さまざまな理由で、返された解の点 x とは異なる可能性があります。例については、最良実行可能点の取得を参照してください。

algorithm

使用される最適化アルゴリズム

message

終了メッセージ

解におけるラグランジュ乗数。次のフィールドをもつ構造体として返されます。

lower

lb に対応する下限

upper

ub に対応する上限

ineqlin

A および b に対応する線形不等式

eqlin

Aeq および beq に対応する線形等式

ineqnonlin

nonlcon の ineqnonlin 関数に対応する非線形不等式

eqnonlin

nonlcon の eqnonlin 関数に対応する非線形等式

解におけるヤコビアン。実数行列として返されます。jacobian(i,j) は、解 x での x(j) に関する fun(i) の偏導関数です。

解にアクティブな制約条件がある問題では、jacobian は信頼区間の推定には有用ではありません。

制限

  • 信頼領域 Reflective 法アルゴリズムは劣決定システムを扱いません。方程式の数、つまり F の行数が少なくとも変数の数と同じである必要があります。劣決定の場合、lsqcurvefit はレーベンバーグ・マルカート法アルゴリズムを使用します。

  • lsqcurvefit は複素数値問題を直接解くことができます。制約は複素数値に対して意味を持たないことに注意してください。なぜなら、複素数はきちんと順序付けされておらず、ある複素数値が他の複素数値より大きいか小さいかを問うことは無意味だからです。範囲制約を使用した複素数問題では、変数を実数部と虚数部に分けます。複素数データに "interior-point" アルゴリズムを使用しないでください。複素数値データへのモデルの当てはめを参照してください。

  • 信頼領域 Reflective 法の前処理付き共役勾配法で使用される前提条件子の計算では、その計算の前に JTJ (J はヤコビ行列) を作成します。そのため多くの非ゼロ要素をもつ J の行は、密行列の積 JTJ に近い結果になり、大規模な問題についてはかなりのコストを要する解法プロセスになる場合があります。

  • x の構成要素に上限 (または下限) がない場合、lsqcurvefit では非常に大きい任意の正の値 (下限に対しては負の値) を設定する代わりに、inf (下限に対しては -inf) を ub (または lb) の対応する構成要素に設定する方がより適切です。

lsqnonlin、lsqcurvefit、fsolve の信頼領域 Reflective 法アルゴリズムは、fun でヤコビアンを計算せずに、あるいはヤコビ スパース パターンを提示せずに、小規模から中規模の問題で使用できます。(これは、ヘッシアンの計算やヘッセ スパース パターンの入力なしで、fmincon または fminunc を使用する場合にも適用されます。) 小、中規模問題とは、どのくらい小さいのでしょうか。絶対的な答えはありません。ご利用のコンピューター システムの構成における仮想メモリ量によって異なるからです。

m 個の方程式と n 個の未知数の問題を考えてみましょう。コマンド J = sparse(ones(m,n)) が Out of memory エラーを引き起こす場合は、間違いなく大きな問題が発生しています。エラーが発生しない場合でも、問題の規模が大きすぎる場合があります。判定するには、問題を実行して MATLAB がシステムで使用可能な仮想メモリ内で実行されるかどうかを確認します。

詳細

すべて折りたたむ

アルゴリズム

レーベンバーグ・マルカート法および信頼領域 Reflective 法は、fsolve にも使用される非線形最小二乗アルゴリズムに基づいています。

  • 既定の信頼領域 Reflective 法アルゴリズムは部分空間の信頼領域法であり、[1] および [2] で説明する interior-reflective ニュートン法に基づいています。各反復は、前処理付き共役勾配 (PCG) 法を使用する大型線形システムの近似解を伴います。信頼領域 Reflective 法の最小二乗を参照してください。

  • レーベンバーグ・マルカート法は [4]、[5]、[6] の参考文献で説明されています。レーベンバーグ・マルカート法を参照してください。

"interior-point" アルゴリズムは fmincon "interior-point" アルゴリズムにいくつかの変更を加えて使用します。詳細については、制約付き最小二乗法に合わせて変更された fmincon アルゴリズムを参照してください。

代替機能

アプリ

[最適化] ライブ エディター タスクが lsqcurvefit にビジュアル インターフェイスを提供します。

参照

[1] Coleman, T.F. and Y. Li. “An Interior, Trust Region Approach for Nonlinear Minimization Subject to Bounds.” SIAM Journal on Optimization, Vol. 6, 1996, pp. 418–445.

[2] Coleman, T.F. and Y. Li. “On the Convergence of Reflective Newton Methods for Large-Scale Nonlinear Minimization Subject to Bounds.” Mathematical Programming, Vol. 67, Number 2, 1994, pp. 189–224.

[3] Dennis, J. E. Jr. “Nonlinear Least-Squares.” State of the Art in Numerical Analysis, ed. D. Jacobs, Academic Press, pp. 269–312.

[4] Levenberg, K. “A Method for the Solution of Certain Problems in Least-Squares.” Quarterly Applied Mathematics 2, 1944, pp. 164–168.

[5] Marquardt, D. “An Algorithm for Least-squares Estimation of Nonlinear Parameters.” SIAM Journal Applied Mathematics, Vol. 11, 1963, pp. 431–441.

[6] Moré, J. J. “The Levenberg-Marquardt Algorithm: Implementation and Theory.” Numerical Analysis, ed. G. A. Watson, Lecture Notes in Mathematics 630, Springer Verlag, 1977, pp. 105–116.

[7] Moré, J. J., B. S. Garbow, and K. E. Hillstrom. User Guide for MINPACK 1. Argonne National Laboratory, Rept. ANL–80–74, 1980.

[8] Powell, M. J. D. “A Fortran Subroutine for Solving Systems of Nonlinear Algebraic Equations.” Numerical Methods for Nonlinear Algebraic Equations, P. Rabinowitz, ed., Ch.7, 1970.

拡張機能

すべて展開する

バージョン履歴

R2006a より前に導入

すべて展開する