メインコンテンツ

lasso

R2026b

線形モデルに対する LASSO または Elastic Net 正則化

説明

B = lasso(X,y) は、予測子データ X および応答 y の線形モデルについて当てはめた最小二乗回帰係数を返します。B の各列は Lambda 内の特定の正則化係数に対応します。既定では、lasso は Lambda の値の等比数列を使用して LASSO 正則化を実行します。

例

B = lasso(X,y,Name=Value) は、1 つ以上の名前と値のペアの引数で指定された追加オプションを使用して、正則化された回帰を当てはめます。たとえば Alpha=0.5 は、パラメーター Alpha が 0.5 に等しい Elastic Net を正則化の手法として設定します。

例

[B,FitInfo] = lasso(___) は、前の構文の入力引数のいずれかを使用して、モデルの当てはめに関する情報が格納されている構造体 FitInfo も返します。

例

例

すべて折りたたむ

冗長な予測子があるデータ セットを作成し、lasso を使用してこれらの予測子を識別します。

100 個の 5 次元正規変数が含まれている行列 X を作成します。X の 2 つの成分のみから応答ベクトル y を作成し、小量のノイズを追加します。

rng default % For reproducibility
X = randn(100,5);
weights = [0;2;0;-3;0]; % Only two nonzero coefficients
y = X*weights + randn(100,1)*0.1; % Small added noise

既定の LASSO 近似を作成します。

B = lasso(X,y);

B 内の 25 番目の Lambda の値について係数ベクトルを求めます。

B(:,25)
ans = 5×1

         0
    1.6093
         0
   -2.5865
         0

lasso は冗長予測子を識別して、削除します。

予測子変数を X、応答変数を y=0+2X+ε として標本データを作成します。

rng default %   For reproducibility
X = rand(100,1);
y = 2*X + randn(100,1)/10;

正則化の値を指定し、切片項のない回帰モデルの係数を求めます。

lambda = 1e-03;
B = lasso(X,y,Lambda=lambda,Intercept=false)
Warning: When the 'Intercept' value is false, the 'Standardize' value is set to false.
B = 
1.9825

予測値 (線) に対して実数値 (点) をプロットします。

scatter(X,y)
hold on
x = 0:0.1:1;
plot(x,x*B)
hold off
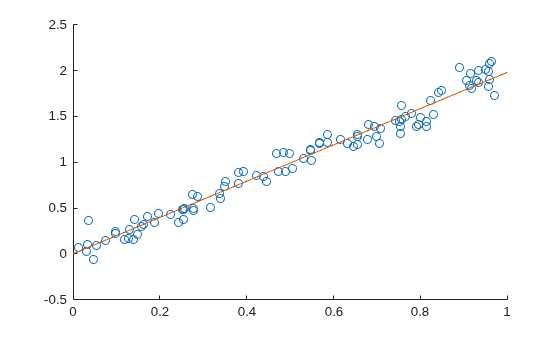
Figure contains an axes object. The axes object contains 2 objects of type scatter, line.

冗長な予測子があるデータ セットを作成し、交差検証された lasso を使用してこれらの予測子を識別します。

100 個の 5 次元正規変数が含まれている行列 X を作成します。X の 2 つの成分から応答ベクトル y を作成し、小量のノイズを追加します。

rng default % For reproducibility
X = randn(100,5);
weights = [0;2;0;-3;0]; % Only two nonzero coefficients
y = X*weights + randn(100,1)*0.1; % Small added noise

予測子変数にラベルを付け、10 分割交差検証を使用して、LASSO 近似を作成します。

[B,FitInfo] = lasso(X,y,CV=10,PredictorNames=["x1","x2","x3","x4","x5"]);

最小の交差検証平均二乗誤差 (MSE) に対応するモデル内の変数を表示します。

idxLambdaMinMSE = FitInfo.IndexMinMSE;
minMSEModelPredictors = FitInfo.PredictorNames(B(:,idxLambdaMinMSE)~=0)
minMSEModelPredictors = 1×2 cell
    {'x2'}    {'x4'}

最小の MSE から 1 標準誤差以内にある、最もスパースなモデル内の変数を表示します。

idxLambda1SE = FitInfo.Index1SE;
sparseModelPredictors = FitInfo.PredictorNames(B(:,idxLambda1SE)~=0)
sparseModelPredictors = 1×2 cell
    {'x2'}    {'x4'}

この例では、lasso は 2 つのモデルについて同じ予測子を識別し、冗長な予測子を削除します。

さまざまな正則化レベルで交差検証誤差を視覚的に調べます。

標本データを読み込みます。

load acetylene

定数項を持たない、交互作用がある計画行列を作成します。

X = [x1 x2 x3];
D = x2fx(X,"interaction");
D(:,1) = []; % No constant term

10 分割交差検証を使用して LASSO 近似を作成します。結果をプロットできるように、出力 FitInfo を含めます。

rng default % For reproducibility 
[B,FitInfo] = lasso(D,y,CV=10);

交差検証した近似をプロットします。緑の円と点線は、交差検証誤差が最小になる Lambda を示しています。青の円と点線は、最小交差検証誤差に 1 標準誤差を加算した点を示しています。

lassoPlot(B,FitInfo,PlotType="CV");
legend("show")
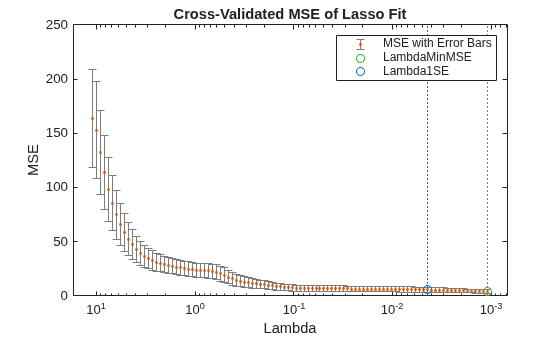
Figure contains an axes object. The axes object with title Cross-Validated MSE of Lasso Fit, xlabel Lambda, ylabel MSE contains 5 objects of type errorbar, line. One or more of the lines displays its values using only markers These objects represent MSE with Error Bars, LambdaMinMSE, Lambda1SE.

lasso と Elastic Net 法を使用して、学生の試験の点数を予測します。

examgrades データ セットを読み込みます。

load examgrades
X = grades(:,1:4);
y = grades(:,5);

データを学習セットとテスト セットに分割します。

n = length(y);
c = cvpartition(n,HoldOut=0.3);
idxTrain = training(c,1);
idxTest = ~idxTrain;
XTrain = X(idxTrain,:);
yTrain = y(idxTrain);
XTest = X(idxTest,:);
yTest = y(idxTest);

10 分割交差検証と Alpha = 0.75 の Elastic Net 法を使用して、正則化された線形回帰モデルの係数を求めます。平均二乗誤差 (MSE) が最小 MSE から 1 標準誤差以内になる最大の Lambda の値を使用します。

[B,FitInfo] = lasso(XTrain,yTrain,Alpha=0.75,CV=10);
idxLambda1SE = FitInfo.Index1SE;
coef = B(:,idxLambda1SE);
coef0 = FitInfo.Intercept(idxLambda1SE);

テスト データについて試験の点数を予測します。基準線を使用して、予測された値を実際の試験の成績と比較します。

yhat = XTest*coef + coef0;
hold on
scatter(yTest,yhat)
plot(yTest,yTest)
xlabel("Actual Exam Grades")
ylabel("Predicted Exam Grades")
hold off
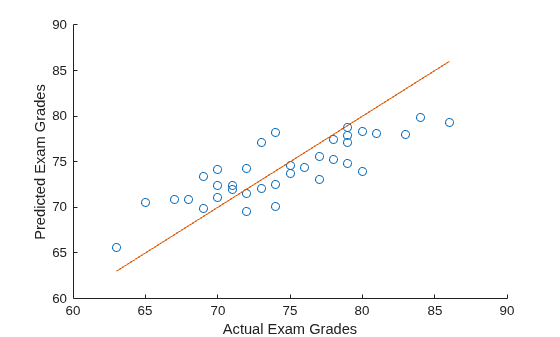
Figure contains an axes object. The axes object with xlabel Actual Exam Grades, ylabel Predicted Exam Grades contains 2 objects of type scatter, line.

N 個の p 次元正規変数が含まれている行列 X を作成します。ここで N は大きく、p = 1000 です。モデル y = beta0 + X*p から加法性ノイズとともに応答ベクトル y を作成します。ここで beta0 は定数です。

rng default % For reproducibility
N = 1e4; % Number of samples
p = 1e3; % Number of features
X = randn(N,p);
beta = randn(p,1); % Multiplicative coefficients
beta0 = randn; % Additive term
y = beta0 + X*beta + randn(N,1); % Last term is noise

既定の LASSO 近似を作成します。作成時間を計ります。

B = lasso(X,y,UseCovariance=false); % Warm up lasso for reliable timing data
tic
B = lasso(X,y,UseCovariance=false);
timefalse = toc
timefalse = 
1.9919

共分散行列を使用して LASSO 当てはめを作成します。作成時間を計ります。

B2 = lasso(X,y,UseCovariance=true); % Warm up lasso for reliable timing data
tic
B2 = lasso(X,y,UseCovariance=true);
timetrue = toc
timetrue = 
0.2147

共分散行列を使用した当てはめ時間は、使用しない場合の時間よりはるかに小さいです。共分散行列を使用した結果の高速化係数を表示します。

speedup = timefalse/timetrue
speedup = 
9.2779

返された係数 B および B2 が似ていることを確認します。

norm(B-B2)/norm(B)
ans = 
5.2508e-15

結果は実質的に同一です。

入力引数

すべて折りたたむ

予測子データ。数値行列として指定します。各行は 1 つの観測値を、各列は 1 つの予測子変数を表します。

データ型: single | double

応答データ。数値ベクトルを指定します。y の長さは n です。n は X の行数です。応答 y(i) は X の i 番目の行に対応します。

データ型: single | double

名前と値の引数

すべて折りたたむ

オプションの引数のペアを Name1=Value1,...,NameN=ValueN として指定します。ここで、Name は引数名で、Value は対応する値です。名前と値の引数は他の引数の後に指定しなければなりませんが、ペアの順序は重要ではありません。

R2021a より前では、コンマを使用して名前と値をそれぞれ区切り、、Name を引用符で囲みます。

例: lasso(X,y,Alpha=0.75,CV=10) は、10 分割交差検証を使用して Elastic Net 正則化を実行します。名前と値のペアの引数 Alpha=0.75 は、Elastic Net 最適化で使用されるパラメーターを設定します。

ADMM アルゴリズムの収束の判定に使用する絶対許容誤差。正のスカラーとして指定します。このアルゴリズムは、係数ベクトルの連続する推定値の差異が AbsTol 未満の量になると収束します。

メモ

このオプションは、tall 配列に対して lasso を使用する場合のみ適用されます。詳細は、拡張機能を参照してください。

例: AbsTol=1e–3

データ型: single | double

リッジ (L2) 最適化に対する LASSO (L1) 最適化の重み。区間 (0,1] の正のスカラー値として指定します。値 Alpha = 1 は LASSO 回帰を表します。0 に近い Alpha はリッジ回帰に近づき、他の値は Elastic Net 最適化を表します。Elastic Netを参照してください。

例: Alpha=0.5

データ型: single | double

ADMM アルゴリズムにおける x の係数の初期値。数値ベクトルとして指定します。

メモ

このオプションは、tall 配列に対して lasso を使用する場合のみ適用されます。詳細は、拡張機能を参照してください。

データ型: single | double

メガバイト単位の共分散行列のサイズ。正のスカラーまたは "maximal" を指定します。関数 lasso は、引数 UseCovariance が true または "auto" の場合、当てはめに共分散行列を使用できます。

UseCovariance が true または "auto" であり、CacheSize が "maximal" である場合、lasso は利用可能なメモリを超える共分散行列を割り当てようとする場合があります。この場合、MATLAB® はエラーを生成します。

例: CacheSize="maximal"

データ型: double | char | string

平均二乗誤差 (MSE) を推定するための交差検証の指定。次のいずれかとして指定します。

  • "resubstitution" — lasso は、交差検証を使用せずに、X と y を使用してモデルを当てはめ、MSE を予測します。

  • 正の整数スカラー K — lasso は K 分割交差検証を使用します。

  • cvpartition オブジェクト cvp — lasso は、cvp で表された交差検証法を使用します。'leaveout' またはカスタムの 'holdout' 分割は lasso と一緒には使用できません。

例: CV=3

モデル内の非ゼロ係数の最大個数。正の整数スカラーとして指定します。lasso は、この基準を満たす Lambda の値のみについて結果を返します。

例: DFmax=5

データ型: single | double

切片項のあるモデルを当てはめるフラグ。true または false のいずれかとして指定します。既定値は true であり、モデルに切片項が含まれることを示しています。Intercept が false の場合、返される切片値は 0 になります。

例: Intercept=false

データ型: logical

正則化係数。非負値のベクトルとして指定します。LASSOを参照してください。

  • Lambda を指定しなかった場合、lasso は非 Null モデルを提供する Lambda の最大値を計算します。この場合、LambdaRatio はシーケンスの最小値/最大値の比を示し、NumLambda はベクトルの長さを示します。

  • Lambda を指定した場合、lasso は LambdaRatio と NumLambda を無視します。

  • Standardize が true である場合、Lambda は、平均がゼロ、分散が 1 になるように X のデータを標準化した状態でモデルを当てはめるために使用された値の集合です。

既定は、最大値だけが B = 0 になる可能性がある、NumLambda の値の等比数列です。

例: Lambda=linspace(0,1)

データ型: single | double

Lambda を指定しなかった場合の、Lambda の最大値に対する最小値の比率。正のスカラーとして指定します。

LambdaRatio = 0 に設定した場合、lasso は Lambda の値について既定の数列を生成し、最小値を 0 に置き換えます。

例: LambdaRatio=1e–2

データ型: single | double

許容される最大反復回数。正の整数スカラーとして指定します。

反復回数が MaxIter 回になっても収束許容誤差 RelTol に達しなかった場合、反復が停止し、警告メッセージが返されます。

NumLambda が 1 より大きい場合、複数の警告が返される可能性があります。

既定値は、標準データの場合は 1e5、tall 配列の場合は 1e4 です。

例: MaxIter=1e3

データ型: single | double

交差検証用のモンテカルロ反復回数。正の整数スカラーとして指定します。

  • CV が "resubstitution" であるか "resubstitution" タイプの cvpartition である場合、MCReps は 1 でなければなりません。

  • CV が "holdout" タイプの cvpartition である場合、MCReps は 1 より大きくなければなりません。

  • CV が "kfold" タイプのカスタムの cvpartition である場合、MCReps は 1 でなければなりません。

例: MCReps=5

データ型: single | double

Lambda を指定しなかった場合に lasso で使用する Lambda の値の個数。正の整数スカラーとして指定します。当てはめの残差誤差が y の分散のしきい値の比率を下回る場合、lasso は NumLambda より少ない個数の当てはめを返す可能性があります。

例: NumLambda=50

データ型: single | double

並列計算と乱数ストリーム設定のオプション。構造体として指定します。並列計算は CV が "resubstitution" の場合は使用されません。statset を使用して Options 構造体を作成します。次の表は、オプションのフィールドとその値の一覧です。

フィールド名値既定の設定
UseParallel

並列計算を行う場合は、この値を "auto" または "on" に設定します。"auto" を指定した場合、利用可能な並列プールがあれば MATLAB はそれを使用し、利用できない場合は逐次実行します。"on" を指定した場合、利用可能な並列プールがあれば MATLAB はそれを使用し、利用できない場合はエラーをスローします。

"off"
UseSubstreams

再現可能な方法で計算する場合は、この値を true に設定します。

再現性のある計算を行うには、Streams をサブストリームを許可する型 ("mlfg6331_64" または "mrg32k3a") に設定します。

false
StreamsRandStream オブジェクトまたはそのようなオブジェクトの cell 配列としてこの値を指定します。UseParallel の値が "on" でも "auto" でもなく、UseSubstreams の値も false でない場合、単一オブジェクトを使用します。この場合は、並列プールと同じサイズの cell 配列を使用します。Streams を指定しなかった場合、lasso は既定のストリームを使用します。

メモ

並列計算を行うには、Parallel Computing Toolbox™ が必要です。

R2026b より前: 並列計算を行うには、UseParallel を true に設定します。

例: Options=statset(UseParallel="auto",UseSubstreams=true,Streams=RandStream("mlfg6331_64"))

データ型: struct

X に現れる順序で並んでいる、予測子変数の名前。string 配列または文字ベクトルの cell 配列として指定します。

例: PredictorNames=["x1","x2","x3","x4"]

データ型: string | cell

座標降下アルゴリズム[3]の収束しきい値。正のスカラーとして指定します。係数ベクトルの連続推定が、L2 ノルムにおいて RelTol 未満の相対的な量の差異がある場合、このアルゴリズムは終了します。

例: RelTol=5e–3

データ型: single | double

ADMM アルゴリズムのための拡張ラグランジュ パラメーター ρ。正のスカラーとして指定します。既定は自動選択です。

メモ

このオプションは、tall 配列に対して lasso を使用する場合のみ適用されます。詳細は、拡張機能を参照してください。

例: Rho=2

データ型: single | double

モデルを当てはめる前に予測子データ X を標準化するフラグ。true または false のいずれか。Standardize が true である場合、平均がゼロ、分散が 1 になるように X のデータがスケーリングされます。Standardize は、標準化されたスケールと元のスケールのどちらで正則化を係数に適用するかに影響を与えます。結果は、常に元のデータ スケールで与えられます。

Intercept が false である場合、指定した Standardize の値にかかわらず、ソフトウェアによって Standardize は false に設定されます。

Intercept が true である場合、X と y は常にセンタリングされます。

例: Standardize=false

データ型: logical

当てはめへの共分散行列の使用の指示。"auto" または logical スカラーとして指定します。

  • "auto" にすると、lasso は、観測値の数が問題の変数の個数を超えた場合、当てはめに共分散行列を使用しようとします。この試行は、メモリが不足している場合、失敗する可能性があります。lasso が当てはめに共分散行列を使用したかどうかを調べるには、FitInfo 出力の UseCovariance フィールドを確認します。

  • true にすると、必要なサイズが CacheSize を超えない限り、lasso は当てはめに共分散行列を使用します。必要な共分散行列のサイズが CacheSize を超えると、lasso は警告を発して、当てはめに共分散行列を使用しません。

  • false にすると、lasso は当てはめに共分散行列を使用しません。

当てはめに共分散行列を使用する方が使用しない場合より高速ですが、必要なメモリが増える可能性があります。LASSO を当てはめるための相関行列の使用を参照してください。高速化が数値安定性にマイナスの影響を与える場合があります。詳細については、座標降下アルゴリズムを参照してください。

例: UseCovariance=true

データ型: logical | char | string

ADMM アルゴリズムにおけるスケーリングされた双対変数 u の初期値。数値ベクトルとして指定します。

メモ

このオプションは、tall 配列に対して lasso を使用する場合のみ適用されます。詳細は、拡張機能を参照してください。

データ型: single | double

観測値の重み。非負のベクトルとして指定します。Weights の長さは n です。ここで、n は X の行数です。関数 lasso は、合計が 1 になるように Weights をスケーリングします。

データ型: single | double

出力引数

すべて折りたたむ

当てはめた係数。数値行列として返されます。B は p 行 L 列の行列です。p は X 内の予測子 (列) の個数、L は Lambda の値の個数です。Lambda の値の個数は、名前と値のペアの引数 NumLambda を使用して指定できます。

切片項に対応する係数は、FitInfo のフィールドです。

データ型: single | double

線形モデルの当てはめ情報。次の表に記載されているフィールドが含まれている構造体として返されます。

FitInfo のフィールド説明
Intercept各線形モデルの切片の項 β0、1 行 L 列のベクトル
Lambda昇順の Lambda パラメーター、1 行 L 列のベクトル
AlphaAlpha パラメーターの値、スカラー値
DFLambda の各値の B 内の非ゼロ係数の数、1 行 L 列のベクトル
MSE平均二乗誤差 (MSE)、1 行 L 列のベクトル
PredictorNamesPredictorNames パラメーターの値、文字ベクトルの cell 配列として格納
UseCovariance当てはめに共分散行列が使用されたかどうかを示す logical 値。共分散が計算され、使用された場合、true になります。そうでない場合は false です。

CV が cvpartition オブジェクトの場合、FitInfo に次の追加フィールドが含まれます。

FitInfo のフィールド説明
SE交差検証中に計算される各 Lambda の MSE の標準誤差、1 行 L 列のベクトル
LambdaMinMSEMSE が最小である Lambda の値、スカラー
Lambda1SEMSE と最小 MSE の差が 1 標準誤差以内になる最大の Lambda の値、スカラー
IndexMinMSE値 LambdaMinMSE の Lambda のインデックス、スカラー
Index1SE値 Lambda1SE の Lambda のインデックス、スカラー

詳細

すべて折りたたむ

アルゴリズム

すべて折りたたむ

参照

[1] Tibshirani, R. “Regression Shrinkage and Selection via the Lasso.” Journal of the Royal Statistical Society. Series B, Vol. 58, No. 1, 1996, pp. 267–288.

[2] Zou, H., and T. Hastie. “Regularization and Variable Selection via the Elastic Net.” Journal of the Royal Statistical Society. Series B, Vol. 67, No. 2, 2005, pp. 301–320.

[3] Friedman, J., R. Tibshirani, and T. Hastie. "Regularization paths for generalized linear models via coordinate descent." Journal of Statistical Software, Vol 33, No. 1, 2010.

[4] Hastie, T., R. Tibshirani, and J. Friedman. The Elements of Statistical Learning. 2nd edition. New York: Springer, 2008.

[5] Boyd, S. “Distributed Optimization and Statistical Learning via the Alternating Direction Method of Multipliers.” Foundations and Trends in Machine Learning. Vol. 3, No. 1, 2010, pp. 1–122.

拡張機能

すべて展開する

バージョン履歴

R2011b で導入

すべて展開する