rrcforest
R2026b構文
説明
関数 rrcforest は、外れ値の検出と新規性の検出のためのロバスト ランダム カット フォレスト モデルの当てはめに使用します。
外れ値検出 (学習データ中の異常を検出) —
rrcforestの出力引数tfを使用して、学習データ中の異常を検出します。新規性の検出 (汚染されていない学習データで新規のデータの異常を検出) — 汚染されていない学習データ (外れ値がないデータ) を
rrcforestに渡してRobustRandomCutForestモデル オブジェクトを作成します。そのオブジェクトと新規データをオブジェクト関数isanomalyに渡して、新規のデータの異常を検出します。
forest = rrcforest(Tbl)Tbl の予測子データに対する RobustRandomCutForest モデル オブジェクトを返します。
forest = rrcforest(___,Name=Value)ContaminationFraction=0.1
例
関数 rrcforest を使用して、外れ値 (学習データ中の異常) を検出します。
標本データ セット NYCHousing2015 を読み込みます。
load NYCHousing2015データ セットには、2015 年のニューヨーク市における不動産の売上に関する情報を持つ 10 の変数が含まれます。データ セットの概要を表示します。
summary(NYCHousing2015)
NYCHousing2015: 91446×10 table

Variables:

    BOROUGH: double
    NEIGHBORHOOD: cell array of character vectors
    BUILDINGCLASSCATEGORY: cell array of character vectors
    RESIDENTIALUNITS: double
    COMMERCIALUNITS: double
    LANDSQUAREFEET: double
    GROSSSQUAREFEET: double
    YEARBUILT: double
    SALEPRICE: double
    SALEDATE: datetime

Statistics for applicable variables:

                             NumMissing          Min              Median               Max               Mean               Std

    BOROUGH                      0                     1                  3                  5             2.8431            1.3343
    NEIGHBORHOOD                 0
    BUILDINGCLASSCATEGORY        0
    RESIDENTIALUNITS             0                     0                  1               8759             2.1789           32.2738
    COMMERCIALUNITS              0                     0                  0                612             0.2201            3.2991
    LANDSQUAREFEET               0                     0               1700           29305534         2.8752e+03        1.0118e+05
    GROSSSQUAREFEET              0                     0               1056            8942176         4.6598e+03        4.3098e+04
    YEARBUILT                    0                     0               1939               2016         1.7951e+03          526.9998
    SALEPRICE                    0                     0             333333         4.1111e+09         1.2364e+06        2.0130e+07
    SALEDATE                     0           01-Jan-2015        09-Jul-2015        31-Dec-2015        07-Jul-2015        2470:47:17
SALEDATE 列は datetime 配列です。rrcforest ではサポートされていません。datetime 値の月番号および日番号用の列を作成し、SALEDATE 列を削除します。
[~,NYCHousing2015.MM,NYCHousing2015.DD] = ymd(NYCHousing2015.SALEDATE);
NYCHousing2015.SALEDATE = [];
列 BOROUGH、NEIGHBORHOOD、および BUILDINGCLASSCATEGORY にはカテゴリカル予測子が含まれます。カテゴリカル予測子のカテゴリの個数を表示します。
length(unique(NYCHousing2015.BOROUGH))
ans =
5
length(unique(NYCHousing2015.NEIGHBORHOOD))
ans =
254
length(unique(NYCHousing2015.BUILDINGCLASSCATEGORY))
ans =
48
64 個を超えるカテゴリをもつカテゴリカル変数の場合、関数 rrcforest は近似分割法を使用しますが、これはロバスト ランダム カット フォレスト モデルの精度を低下させる可能性があります。254 個のカテゴリをもつカテゴリカル変数が含まれている NEIGHBORHOOD 列を削除します。
NYCHousing2015.NEIGHBORHOOD = [];
ロバスト ランダム カット フォレスト モデルに NYCHousing2015 について学習させます。学習観測値に含まれている異常の比率を 0.1 に指定し、最初の変数 (BOROUGH) をカテゴリカル予測子として指定します。最初の変数は数値配列であるため、この変数をカテゴリカル変数として指定しない限り、rrcforest により連続変数であると仮定されます。
rng("default") % For reproducibility
[Mdl,tf,scores] = rrcforest(NYCHousing2015, ...
    ContaminationFraction=0.1,CategoricalPredictors=1);
Mdl は RobustRandomCutForest モデル オブジェクトです。rrcforest は、学習データ NYCHousing2015 の異常インジケーター (tf) および異常スコア (scores) も返します。
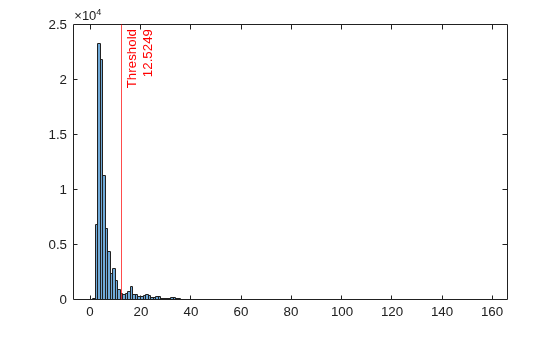
スコア値のヒストグラムをプロットします。指定した比率に対応するスコアのしきい値に垂直線を作成します。
histogram(scores)
xline(Mdl.ScoreThreshold,"r-",["Threshold" Mdl.ScoreThreshold])
異なる汚染の比率 (たとえば 0.01) で異常を識別する場合は、新しいロバスト ランダム カット フォレスト モデルに学習させることができます。
rng("default") % For reproducibility
[newMdl,newtf,scores] = rrcforest(NYCHousing2015, ...
    ContaminationFraction=0.01,CategoricalPredictors=1);
異なるスコアのしきい値 (たとえば 65) で異常を識別する場合は、RobustRandomCutForest モデル オブジェクト、学習データ、および新しいしきい値を関数 isanomaly に渡せます。
[newtf,scores] = isanomaly(Mdl,NYCHousing2015,ScoreThreshold=65);
汚染の比率またはスコアのしきい値を変更すると異常インジケーターのみが変更され、異常スコアは影響を受けないことに注意してください。したがって、rrcforest または isanomaly を使用して異常スコアを再度計算しない場合、既存のスコア値を使用して新しい異常インジケーターを取得できます。
学習データ中の異常の比率を 0.01 に変更します。
newContaminationFraction = 0.01;
関数quantileを使用して、新しいスコアのしきい値を求めます。
newScoreThreshold = quantile(scores,1-newContaminationFraction)
newScoreThreshold =
63.2642
新しい異常インジケーターを取得します。
newtf = scores > newScoreThreshold;
関数 rrcforest を使用して、汚染されていない学習観測値用の RobustRandomCutForest モデル オブジェクトを作成します。次に、オブジェクトおよび新規データをオブジェクト関数 isanomaly に渡して、新規性 (新規データ中の異常) を検出します。
census1994.mat に保存されている 1994 年の国勢調査データを読み込みます。このデータ セットには、個人の年収が $50,000 を超えるかどうかを予測するための、米国勢調査局の人口統計データが含まれています。
load census1994census1994 には学習データ セット adultdata およびテスト データ セット adulttest が含まれています。
adultdata には外れ値が含まれていないと仮定します。ロバスト ランダム カット フォレスト モデルに adultdata について学習させます。StandardizeData を true と指定して入力データを標準化します。
rng("default") % For reproducibility
[Mdl,tf,s] = rrcforest(adultdata,StandardizeData=true);
Mdl は RobustRandomCutForest モデル オブジェクトです。rrcforest は、学習データ adultdata の異常インジケーター tf および異常スコア s も返します。名前と値の引数 ContaminationFraction を 0 を超える値として指定していない場合、rrcforest はすべての学習観測値を正常な観測値として扱います。つまり tf の値はすべて logical 0 (false) となります。この関数によりスコアのしきい値が最大のスコア値に設定されます。しきい値を表示します。
Mdl.ScoreThreshold
ans =
86.5315
学習させたロバスト ランダム カット フォレスト モデルを使用して、adulttest 内の異常を見つけます。モデルに学習させるときに StandardizeData=true を指定したため、関数 isanomaly は、Mu プロパティと Sigma プロパティに格納されている学習データの予測子の平均と標準偏差をそれぞれ使用して入力データを標準化します。
[tf_test,s_test] = isanomaly(Mdl,adulttest);
関数 isanomaly は、adulttest の異常インジケーター tf_test およびスコア s_test を返します。既定では、isanomaly はしきい値 (Mdl.ScoreThreshold) を超えるスコアをもつ観測値を異常として識別します。
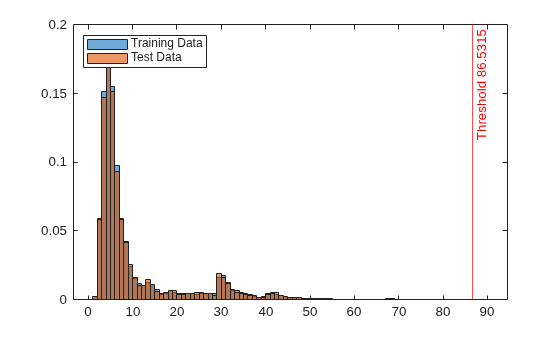
異常スコア s および s_test のヒストグラムを作成します。異常スコアのしきい値に垂直線を作成します。
histogram(s,Normalization="probability")
hold on
histogram(s_test,Normalization="probability")
xline(Mdl.ScoreThreshold,"r-",join(["Threshold" Mdl.ScoreThreshold]))
legend("Training Data","Test Data",Location="northwest")
hold off
テスト データ中にある異常の観測値のインデックスを表示します。
find(tf_test)
ans =
3541
テスト データの異常スコア分布は学習データの異常スコア分布と類似しているため、isanomaly は既定のしきい値でテスト データ中にある少数の異常を検出します。
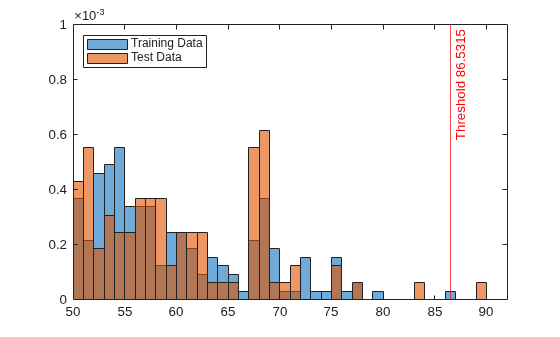
しきい値近くの異常と観測値が見えるようにズームインします。
xlim([50 92])
ylim([0 0.001])
名前と値のペア ScoreThreshold を使用して、異なるしきい値を指定できます。例については、異常スコアのしきい値の指定を参照してください。
入力引数
名前と値の引数
出力引数
詳細
アルゴリズム
rrcforest は、Tbl に含まれている NaN、'' (空の文字ベクトル)、"" (空の string)、<missing>、<undefined> の値と X に含まれている NaN 値を欠損値と見なします。
rrcforest は、欠損値を含む観測値を使用して、それらの観測値が有効な値をもつ変数の分岐を特定します。それらの観測値は、葉ノードではなく枝ノードに配置されることがあります。その場合、rrcforest は、それぞれの木について、枝ノードからルート ノードまで移動して比率 (Disp(x,C)/|C|) を計算します。すべての値が欠損値である観測値はルート ノードに配置されます。そのため、比率および異常スコアは、それぞれの木の学習観測値の数になります。これは、学習済みのロバスト ランダム カット フォレスト モデルで求められる異常スコアの最大値に相当します。それぞれの木の学習観測値の数は、名前と値の引数 NumObservationsPerLearner を使用して指定できます。
参照
[1] Guha, Sudipto, N. Mishra, G. Roy, and O. Schrijvers. "Robust Random Cut Forest Based Anomaly Detection on Streams," Proceedings of The 33rd International Conference on Machine Learning 48 (June 2016): 2712–21.
[2] Bartos, Matthew D., A. Mullapudi, and S. C. Troutman. "rrcf: Implementation of the Robust Random Cut Forest Algorithm for Anomaly Detection on Streams." Journal of Open Source Software 4, no. 35 (2019): 1336.

