predict
R2026b線形分類モデルのラベルの予測
説明
例
NLP のデータ セットを読み込みます。
load nlpdataX は予測子データのスパース行列、Y はクラス ラベルの categorical ベクトルです。データには 2 つを超えるクラスがあります。
モデルでは、ある Web ページの単語数が Statistics and Machine Learning Toolbox™ ドキュメンテーションによるものであるかどうかを識別できなければなりません。したがって、Statistics and Machine Learning Toolbox™ のドキュメンテーション Web ページに対応するラベルを識別します。
Ystats = Y == "stats";あるドキュメンテーション Web ページの単語数が Statistics and Machine Learning Toolbox™ ドキュメンテーションによるものであるかどうかを識別できるバイナリ線形分類モデルに、データ セット全体を使用して学習をさせます。
rng(1) % For reproducibility
Mdl = fitclinear(X,Ystats);
Mdl は ClassificationLinear モデルです。
学習標本 (再代入) のラベルを予測します。
label = predict(Mdl,X);
Mdl 内の正則化強度は 1 つなので、label は長さが観測値数に等しい列ベクトルになります。
混同行列を作成します。
ConfusionTrain = confusionchart(Ystats,label);
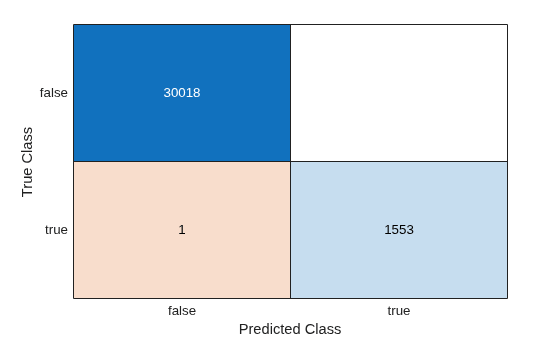
このモデルは、1 つの "stats" ドキュメンテーション ページのみを Statistics and Machine Learning Toolbox ドキュメンテーションの外部にあるとして誤分類します。
NLP のデータ セットを読み込み、学習標本のラベルの予測 で説明されているように前処理します。予測子データ行列を転置します。
load nlpdata
Ystats = Y == "stats";
X = X';
あるドキュメンテーション Web ページの単語数が Statistics and Machine Learning Toolbox™ ドキュメンテーションによるものであるかどうかを識別できるバイナリ線形分類モデルに学習をさせます。観測値の 30% をホールドアウトするように指定します。SpaRSA を使用して目的関数を最適化します。
rng(1) % For reproducibility
CVMdl = fitclinear(X,Ystats,Solver="sparsa",Holdout=0.30, ...
    ObservationsIn="columns");
Mdl = CVMdl.Trained{1};
CVMdl は ClassificationPartitionedLinear モデルです。これには Trained プロパティが含まれています。これは 1 行 1 列の cell 配列で、学習セットにより学習させた ClassificationLinear モデルが格納されています。
学習データとテスト データを分割の定義から抽出します。
trainIdx = training(CVMdl.Partition);
testIdx = test(CVMdl.Partition);
学習標本および検定標本のラベルを予測します。
labelTrain = predict(Mdl,X(:,trainIdx),ObservationsIn="columns");
labelTest = predict(Mdl,X(:,testIdx),ObservationsIn="columns");
Mdl 内の正則化強度は 1 つなので、labelTrain と labelTest はそれぞれ長さが学習観測値数および検定観測値数に等しい列ベクトルになります。
学習データの混同行列を作成します。
ConfusionTrain = confusionchart(Ystats(trainIdx),labelTrain);
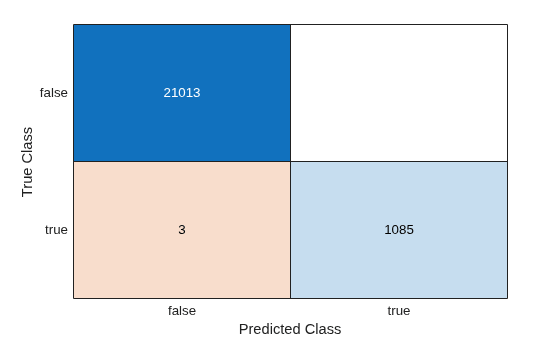
このモデルは、3 つのドキュメンテーション ページのみを Statistics and Machine Learning Toolbox ドキュメンテーションの外部にあるとして誤分類します。
テスト データの混同行列を作成します。
ConfusionTest = confusionchart(Ystats(testIdx),labelTest);
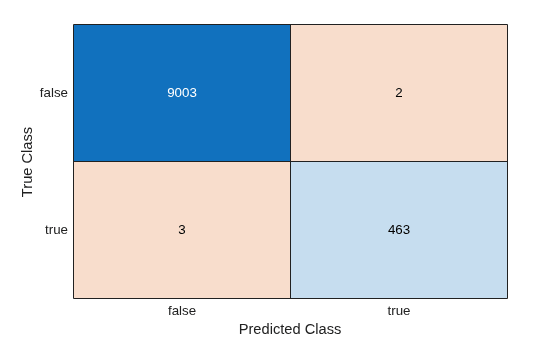
このモデルは、3 つのドキュメンテーション ページを Statistics and Machine Learning Toolbox ドキュメンテーションの外部、2 つのページを内部にあると誤分類します。
検定標本の事後クラス確率を推定し、受信者動作特性 (ROC) 曲線をプロットしてモデルの品質を判定します。線形分類モデルは、ロジスティック回帰学習器の場合のみ事後確率を返します。
NLP のデータ セットを読み込み、検定標本のラベルの予測 で説明されているように前処理します。
load nlpdata
Ystats = Y == "stats";
X = X';
30% のホールドアウト標本を指定して、データを無作為に学習セットとテスト セットに分割します。テスト セットのインデックスを特定します。
cvp = cvpartition(Ystats,Holdout=0.30);
idxTest = test(cvp);
バイナリ線形分類モデルに学習をさせます。SpaRSA を使用してロジスティック回帰学習器を当てはめます。テスト セットをホールドアウトするため、分割済みのモデルを指定します。
CVMdl = fitclinear(X,Ystats,ObservationsIn="columns",CVPartition=cvp, ...
    Learner="logistic",Solver="sparsa");
Mdl = CVMdl.Trained{1};
Mdl は、分割 cvp で指定される学習セットのみを使用して学習を行った ClassificationLinear モデルです。
検定標本の事後クラス確率を予測します。
[~,posterior] = predict(Mdl,X(:,idxTest),ObservationsIn="columns");Mdl 内の正則化強度は 1 つなので、posterior は列数が 2 で行数がテスト セットの観測値数と同じである行列になります。列 i には、与えられた特定の観測値に対する Mdl.ClassNames(i) の事後確率が格納されます。
rocmetricsオブジェクトを作成し、ROC 曲線のパフォーマンス メトリクス (真陽性率と偽陽性率) を計算して ROC 曲線の下の領域 (AUC) の値を求めます。
rocObj = rocmetrics(Ystats(idxTest),posterior,Mdl.ClassNames);
rocmetrics の関数 plot を使用して、2 番目のクラスの ROC 曲線をプロットします。
plot(rocObj,ClassNames=Mdl.ClassNames(2))
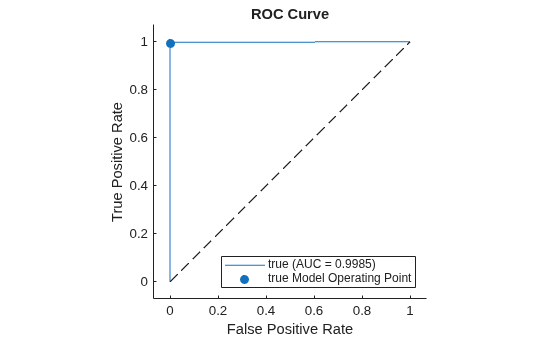
ROC 曲線から、モデルが検定標本の観測値をほぼ完璧に分類することがわかります。
ロジスティック回帰学習器を使用する線形分類モデルに適した LASSO ペナルティの強度を決定するため、AUC の検定標本の値を比較します。
NLP のデータ セットを読み込みます。検定標本のラベルの予測で説明されているようにデータを前処理します。
load nlpdata
Ystats = Y == "stats";
X = X';
観測値の 10% をホールドアウトするように指定するデータ分割を作成します。検定標本のインデックスを抽出します。
rng(10) % For reproducibility
Partition = cvpartition(Ystats,Holdout=0.10);
testIdx = test(Partition);
XTest = X(:,testIdx);
n = sum(testIdx)
n = 3157
YTest = Ystats(testIdx);
検定標本には 3157 個の観測値があります。
~ の範囲で対数間隔で配置された 11 個の正則化強度を作成します。
Lambda = logspace(-6,-0.5,11);
各正則化強度を使用するバイナリ線形分類モデルに学習をさせます。SpaRSA を使用して目的関数を最適化します。目的関数の勾配の許容誤差を 1e-8 に下げます。
CVMdl = fitclinear(X,Ystats,ObservationsIn="columns", ...
    CVPartition=Partition,Learner="logistic",Solver="sparsa", ...
    Regularization="lasso",Lambda=Lambda,GradientTolerance=1e-8)
CVMdl =
  ClassificationPartitionedLinear
    CrossValidatedModel: 'Linear'
           ResponseName: 'Y'
        NumObservations: 31572
                  KFold: 1
              Partition: [1×1 cvpartition]
             ClassNames: [0 1]
         ScoreTransform: 'none'


  Properties, Methods
学習済みの線形分類モデルを抽出します。
Mdl1 = CVMdl.Trained{1}Mdl1 =
ClassificationLinear
ResponseName: 'Y'
ClassNames: [0 1]
ScoreTransform: 'logit'
Beta: [34023×11 double]
Bias: [-11.9079 -11.9079 -11.9079 -11.9079 -9.3362 -6.4290 -5.1424 -4.4991 -3.5732 -3.1742 -2.9839]
Lambda: [1.0000e-06 3.5481e-06 1.2589e-05 4.4668e-05 1.5849e-04 5.6234e-04 0.0020 0.0071 0.0251 0.0891 0.3162]
Learner: 'logistic'
Properties, Methods
Mdl は ClassificationLinear モデル オブジェクトです。Lambda は正則化強度のシーケンスなので、Mdl はそれぞれが Lambda の各正則化強度に対応する 11 個のモデルであると考えることができます。
検定標本の予測ラベルと事後クラス確率を推定します。
[label,posterior] = predict(Mdl1,XTest,ObservationsIn="columns");
Mdl1.ClassNames;
posterior(3,1,5)
ans = 1.0000
label は、予測されたラベルが含まれている 3157 行 11 列の行列です。各列は、対応する正則化強度を使用して学習を行ったモデルの予測ラベルに対応します。posterior は事後クラス確率が含まれている 3157 x 2 x 11 の行列です。列はクラスに対応し、ページは正則化強度に対応します。たとえば、posterior(3,1,5) は、正則化強度として Lambda(5) を使用するモデルによって 1 番目のクラス (ラベルは 0) が観測値 3 に割り当てられる事後確率を示し、値は 1.0000 です。
それぞれのモデルについて、rocmetricsを使用して AUC を計算します。
auc = 1:numel(Lambda);
for j = 1:numel(Lambda)
    rocObj = rocmetrics(YTest,posterior(:,:,j),Mdl1.ClassNames);
    auc(j) = rocObj.AUC(1);
end
Lambda の値が大きくなると、予測子変数がスパースになります。これは分類器の品質として優れています。データ セット全体を使用し、モデルに学習をさせたときと同じオプションを指定して、各正則化強度について線形分類モデルに学習をさせます。モデルごとに非ゼロの係数を特定します。
Mdl = fitclinear(X,Ystats,ObservationsIn="columns", ...
    Learner="logistic",Solver="sparsa",Regularization="lasso", ...
    Lambda=Lambda,GradientTolerance=1e-8);
numNZCoeff = sum(Mdl.Beta~=0);
同じ図に、各正則化強度についてのテスト標本の誤差率と非ゼロ係数の頻度をプロットします。すべての変数を対数スケールでプロットします。
figure
yyaxis left
plot(log10(Lambda),log10(auc),"o-")
ylabel("log_{10} AUC")
yyaxis right
plot(log10(Lambda),log10(numNZCoeff + 1),"o-")
ylabel("log_{10} nonzero-coefficient frequency")
xlabel("log_{10} Lambda")
title("Test-Sample Statistics")
hold off
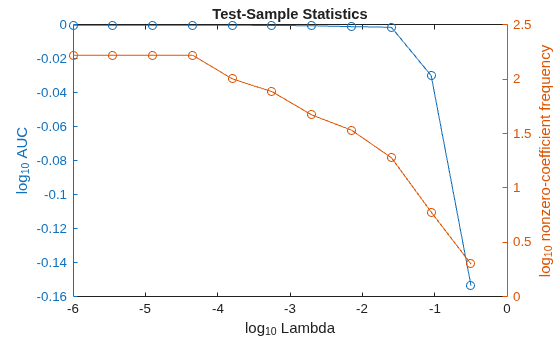
予測子変数のスパース性と AUC の高さのバランスがとれている正則化強度のインデックスを選択します。この場合、 ~ の値で十分なはずです。
idxFinal = 9;
選択した正則化強度のモデルを Mdl から選択します。
MdlFinal = selectModels(Mdl,idxFinal);
MdlFinal は、1 つの正則化強度が含まれている ClassificationLinear モデルです。新しい観測値のラベルを推定するには、MdlFinal と新しいデータを predict に渡します。
入力引数
出力引数
詳細
代替機能
Simulink ブロック
Simulink® に線形分類モデルの予測を統合するには、Statistics and Machine Learning Toolbox™ ライブラリにある ClassificationLinear Predict ブロックを使用するか、MATLAB® Function ブロックを predict 関数と共に使用します。例については、ClassificationLinear Predict ブロックの使用によるクラス ラベルの予測とMATLAB Function ブロックの使用によるクラス ラベルの予測を参照してください。
使用するアプローチを判断する際は、以下を考慮してください。
Statistics and Machine Learning Toolbox ライブラリ ブロックを使用する場合、固定小数点ツール (Fixed-Point Designer)を使用して浮動小数点モデルを固定小数点に変換できます。
MATLAB Function ブロックを関数
predictと共に使用する場合は、可変サイズの配列に対するサポートを有効にしなければなりません。MATLAB Function ブロックを使用する場合、予測の前処理や後処理のために、同じ MATLAB Function ブロック内で MATLAB 関数を使用することができます。

