edge
R2026b線形分類モデルの分類エッジ
説明
e = edge(Mdl,Tbl,ResponseVarName)Tbl に含まれている予測子データと Tbl.ResponseVarName に含まれているクラス ラベルを使用して、学習済み線形分類器 Mdl の分類エッジを返します。
e = edge(___,Name=Value)
メモ
予測子データ X または Tbl 内の予測子変数に欠損値がある場合、関数 edge で NaN が返されることがあります。詳細については、欠損値がある予測子データに対して edge で NaN が返されることがあるを参照してください。
例
NLP のデータ セットを読み込みます。
load nlpdataX は予測子データのスパース行列、Y はクラス ラベルの categorical ベクトルです。データには 2 つを超えるクラスがあります。
モデルでは、ある Web ページの単語数が Statistics and Machine Learning Toolbox™ ドキュメンテーションによるものであるかどうかを識別できなければなりません。したがって、Statistics and Machine Learning Toolbox™ のドキュメンテーション Web ページに対応するラベルを識別します。
Ystats = Y == "stats";あるドキュメンテーション Web ページの単語数が Statistics and Machine Learning Toolbox™ ドキュメンテーションによるものであるかどうかを識別できるバイナリ線形分類モデルに学習をさせます。観測値の 30% をホールドアウトするように指定します。SpaRSA を使用して目的関数を最適化します。
rng(1) % For reproducibility
CVMdl = fitclinear(X,Ystats,Solver="sparsa",Holdout=0.30);
CMdl = CVMdl.Trained{1};
CVMdl は ClassificationPartitionedLinear モデルです。これには Trained プロパティが含まれています。これは 1 行 1 列の cell 配列で、学習セットにより学習させた ClassificationLinear モデルが格納されています。
学習データとテスト データを分割の定義から抽出します。
trainIdx = training(CVMdl.Partition);
testIdx = test(CVMdl.Partition);
学習標本とテスト標本のエッジを推定します。
eTrain = edge(CMdl,X(trainIdx,:),Ystats(trainIdx))
eTrain =
15.6660
eTest = edge(CMdl,X(testIdx,:),Ystats(testIdx))
eTest =
15.4767
特徴選択を行う方法の 1 つとして、複数のモデルからテスト標本エッジを比較します。この条件のみに基づくと、エッジが最高となる分類器が最善の分類器となります。
NLP のデータ セットを読み込みます。
load nlpdataX は予測子データのスパース行列、Y はクラス ラベルの categorical ベクトルです。データには 2 つを超えるクラスがあります。
モデルでは、ある Web ページの単語数が Statistics and Machine Learning Toolbox™ ドキュメンテーションによるものであるかどうかを識別できなければなりません。したがって、Statistics and Machine Learning Toolbox™ のドキュメンテーション Web ページに対応するラベルを識別します。実行時間を短縮するため、各観測値が列に対応するように予測子データを配置します。
Ystats = Y == "stats";
X = X';
rng(1) % For reproducibility
テスト用に観測値の 30% をホールドアウトするデータ分割を作成します。
Partition = cvpartition(Ystats,Holdout=0.30);
testIdx = test(Partition);
XTest = X(:,testIdx);
YTest = Ystats(testIdx);
Partition は、データ セットの分割を定義する cvpartition オブジェクトです。
予測子変数の半分を無作為に選択します。
p = size(X,1);
idxPart = randsample(p,ceil(0.5*p));
2 つのバイナリ線形分類モデルに学習させます。1 つではすべての予測子を、もう 1 つでは半分の予測子を使用します。観測値が列に対応することを指定し、SpaRSA を使用して目的関数を最適化します。
CVMdl = fitclinear(X,Ystats,CVPartition=Partition,Solver="sparsa", ...
    ObservationsIn="columns");
PCVMdl = fitclinear(X(idxPart,:),Ystats,CVPartition=Partition,Solver="sparsa", ...
    ObservationsIn="columns");
CVMdl および PCVMdl は ClassificationPartitionedLinear モデルです。
学習済みの ClassificationLinear モデルを交差検証済みモデルから抽出します。
CMdl = CVMdl.Trained{1};
PCMdl = PCVMdl.Trained{1};
分類器ごとにテスト標本エッジを推定します。
fullEdge = edge(CMdl,XTest,YTest,ObservationsIn="columns")fullEdge = 15.4767
partEdge = edge(PCMdl,XTest(idxPart,:),YTest,ObservationsIn="columns")partEdge = 13.4458
テスト標本のエッジに基づくと、すべての予測子を使用する分類器の方がモデルとして優れています。
ロジスティック回帰学習器を使用する線形分類モデルに適した LASSO ペナルティの強度を決定するため、テスト標本のエッジを比較します。
NLP のデータ セットを読み込みます。テスト標本のエッジを使用した特徴選択で説明されているようにデータを前処理します。
load nlpdata
Ystats = Y == "stats";
X = X';

Partition = cvpartition(Ystats,Holdout=0.30);
testIdx = test(Partition);
XTest = X(:,testIdx);
YTest = Ystats(testIdx);
~ の範囲で対数間隔で配置された 11 個の正則化強度を作成します。
Lambda = logspace(-8,1,11);
各正則化強度を使用するバイナリ線形分類モデルに学習をさせます。SpaRSA を使用して目的関数を最適化します。目的関数の勾配の許容誤差を 1e-8 に下げます。
rng(10) % For reproducibility
CVMdl = fitclinear(X,Ystats,ObservationsIn="columns", ...
    CVPartition=Partition,Learner="logistic",Solver="sparsa", ...
    Regularization="lasso",Lambda=Lambda,GradientTolerance=1e-8)
CVMdl =
  ClassificationPartitionedLinear
    CrossValidatedModel: 'Linear'
           ResponseName: 'Y'
        NumObservations: 31572
                  KFold: 1
              Partition: [1×1 cvpartition]
             ClassNames: [0 1]
         ScoreTransform: 'none'


  Properties, Methods
学習済みの線形分類モデルを抽出します。
Mdl = CVMdl.Trained{1}Mdl =
ClassificationLinear
ResponseName: 'Y'
ClassNames: [0 1]
ScoreTransform: 'logit'
Beta: [34023×11 double]
Bias: [-11.3599 -11.3599 -11.3599 -11.3599 -11.3599 -7.2163 -5.1919 -3.7624 -3.1671 -2.9610 -2.9610]
Lambda: [1.0000e-08 7.9433e-08 6.3096e-07 5.0119e-06 3.9811e-05 3.1623e-04 0.0025 0.0200 0.1585 1.2589 10]
Learner: 'logistic'
Properties, Methods
Mdl は ClassificationLinear モデル オブジェクトです。Lambda は正則化強度のシーケンスなので、Mdl はそれぞれが Lambda の各正則化強度に対応する 11 個のモデルであると考えることができます。
テスト標本のエッジを推定します。
e = edge(Mdl,X(:,testIdx),Ystats(testIdx),ObservationsIn="columns")e = 1×11
0.9986 0.9986 0.9986 0.9986 0.9986 0.9933 0.9765 0.9202 0.8340 0.8128 0.8128
11 個の正則化強度があるので、e は 1 行 11 列のエッジのベクトルです。
各正則化強度についてテスト標本のエッジをプロットします。グリッド全体でエッジを最大化する正則化強度を特定します。
figure
plot(log10(Lambda),log10(e),"-o")
[~, maxEIdx] = max(e);
maxLambda = Lambda(maxEIdx);
hold on
plot(log10(maxLambda),log10(e(maxEIdx)),"ro");
ylabel("log_{10} test-sample edge")
xlabel("log_{10} Lambda")
legend("Edge","Max edge")
hold off
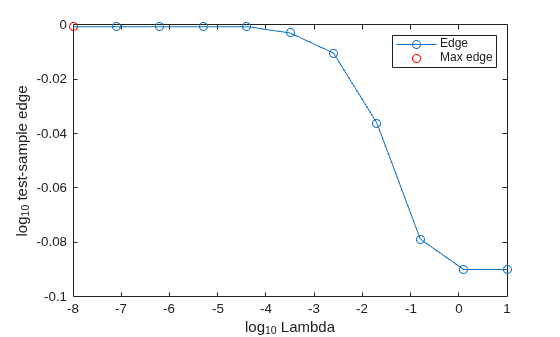
いくつかの Lambda の値で同じようにエッジが高くなっています。Lambda の値が大きくなると、予測子変数がスパースになります。これは分類器の品質として優れています。
エッジが低下する直前にある正則化強度を選択します。
LambdaFinal = Lambda(5);
データ セット全体を使用して線形分類モデルに学習をさせ、エッジが最大になる正則化強度を指定します。
MdlFinal = fitclinear(X,Ystats,ObservationsIn="columns", ...
    Learner="logistic",Solver="sparsa",Regularization="lasso", ...
    Lambda=LambdaFinal);
新しい観測値のラベルを推定するには、MdlFinal と新しいデータを predict に渡します。
入力引数
名前と値の引数
出力引数
詳細
アルゴリズム
既定の設定では、観測値の重みはクラスの事前確率です。Weights を使用して重みを指定した場合、合計がそれぞれのクラスの事前確率になるように正規化されます。重み付きエッジの推定には、正規化された重みが使用されます。

