resubPredict
R2026bマルチクラス誤り訂正出力符号 (ECOC) モデル内の観測値を分類
構文
説明
label = resubPredict(Mdl,Name,Value)
例
フィッシャーのアヤメのデータ セットを読み込みます。予測子データ X、応答データ Y、および Y 内のクラスの順序を指定します。
load fisheriris
X = meas;
Y = categorical(species);
classOrder = unique(Y);
SVM バイナリ分類器を使用して ECOC モデルを学習させます。SVM テンプレートを使用して予測子を標準化し、クラスの順序を指定します。
t = templateSVM('Standardize',true);
Mdl = fitcecoc(X,Y,'Learners',t,'ClassNames',classOrder);
t は SVM テンプレート オブジェクトです。学習時は、t の空のプロパティに対して既定値が使用されます。Mdl は ClassificationECOC モデルです。
学習データのラベルを予測します。真のラベルと予測されたラベルのランダムなサブセットを印刷します。
labels = resubPredict(Mdl);

rng(1); % For reproducibility
n = numel(Y); % Sample size
idx = randsample(n,10);
table(Y(idx),labels(idx),'VariableNames',{'TrueLabels','PredictedLabels'})
ans = 10×2 table
    TrueLabels    PredictedLabels
    __________    _______________

    setosa          setosa
    versicolor      versicolor
    virginica       virginica
    setosa          setosa
    versicolor      versicolor
    setosa          setosa
    versicolor      versicolor
    versicolor      versicolor
    setosa          setosa
    setosa          setosa
Mdl は、インデックス idx をもつ観測値に正確なラベルを付けます。
フィッシャーのアヤメのデータ セットを読み込みます。予測子データ X、応答データ Y、および Y 内のクラスの順序を指定します。
load fisheriris
X = meas;
Y = categorical(species);
classOrder = unique(Y); % Class order
SVM バイナリ分類器を使用して ECOC モデルを学習させます。SVM テンプレートを使用して予測子を標準化し、クラスの順序を指定します。
t = templateSVM('Standardize',true);
Mdl = fitcecoc(X,Y,'Learners',t,'ClassNames',classOrder);
t は SVM テンプレート オブジェクトです。学習時は、t の空のプロパティに対して既定値が使用されます。Mdl は ClassificationECOC モデルです。
SVM スコアは観測から判定境界までの符号付き距離です。したがって、定義域は です。以下を行うカスタム バイナリ損失関数を作成します。
各学習器の符号化設計行列 (M) と陽性クラスの分類スコア (s) を各観測値のバイナリ損失にマッピングする。
線形損失を使用する。
中央値を使用してバイナリ学習器の損失を集計する。
バイナリ損失関数用に独立した関数を作成し、MATLAB® パスに保存できます。あるいは、無名バイナリ損失関数を指定できます。この場合、無名バイナリ損失関数に対する関数ハンドル (customBL) を作成します。
customBL = @(M,s)median(1 - (M.*s),2,'omitnan')/2;学習データのラベルを予測し、クラスごとのバイナリ損失の中央値を推定します。10 件の観測の無作為セットについて、クラスごとに中央値の符号を反転したバイナリ損失を出力します。
[label,NegLoss] = resubPredict(Mdl,'BinaryLoss',customBL);

rng(1); % For reproducibility
n = numel(Y); % Sample size
idx = randsample(n,10);
classOrder
classOrder = 3×1 categorical
     setosa
     versicolor
     virginica
table(Y(idx),label(idx),NegLoss(idx,:),'VariableNames',...
    {'TrueLabel','PredictedLabel','NegLoss'})
ans = 10×3 table
    TrueLabel     PredictedLabel                NegLoss
    __________    ______________    _______________________________

    setosa          versicolor       0.1236      1.9565     -3.5801
    versicolor      versicolor      -1.0169       0.629     -1.1121
    virginica       virginica       -1.9079    -0.21788     0.62583
    setosa          versicolor      0.43825      2.2437      -4.182
    versicolor      versicolor      -1.0732       0.396    -0.82276
    setosa          versicolor      0.26653      2.1999     -3.9664
    versicolor      versicolor      -1.1233      0.6988     -1.0755
    versicolor      versicolor      -1.2708     0.51782      -0.747
    setosa          versicolor      0.35168      2.0674     -3.9191
    setosa          versicolor       0.2334      2.1882     -3.9216
列の順序は classOrder の要素に対応します。符号が反転した最大損失に基づき、ラベルが予測されます。この結果は、線形損失の中央値が他の損失ほどは効果的に機能しないことを示しています。
SVM バイナリ学習器を使用して ECOC 分類器に学習をさせます。はじめに、学習標本のラベルとクラス事後確率を予測します。次に、グリッド内の各点における最大のクラス事後確率を予測します。結果を可視化します。
フィッシャーのアヤメのデータ セットを読み込みます。予測子として花弁の寸法を、応答として種の名前を指定します。
load fisheriris
X = meas(:,3:4);
Y = species;
rng(1) % For reproducibility
SVM テンプレートを作成します。予測子を標準化し、ガウス カーネルを指定します。
t = templateSVM(Standardize=true,KernelFunction="gaussian");t は SVM テンプレートです。ほとんどのプロパティは空です。ECOC 分類器を学習させると、適用可能なプロパティが既定値に設定されます。
SVM テンプレートを使用して ECOC 分類器を学習させます。名前と値の引数 FitPosterior を使用して、分類スコアをクラス事後確率 (predict または resubPredict により返される) に変換します。名前と値の引数 ClassNames を使用して、クラスの順序を指定します。名前と値の引数 Verbose を使用して、学習中に診断メッセージを表示します。
Mdl = fitcecoc(X,Y,Learners=t,FitPosterior=true, ...
    ClassNames=["setosa","versicolor","virginica"], ...
    Verbose=2);
Training binary learner 1 (SVM) out of 3 with 50 negative and 50 positive observations.
Negative class indices: 2
Positive class indices: 1

Fitting posterior probabilities for learner 1 (SVM).
Training binary learner 2 (SVM) out of 3 with 50 negative and 50 positive observations.
Negative class indices: 3
Positive class indices: 1

Fitting posterior probabilities for learner 2 (SVM).
Training binary learner 3 (SVM) out of 3 with 50 negative and 50 positive observations.
Negative class indices: 3
Positive class indices: 2

Fitting posterior probabilities for learner 3 (SVM).
Mdl は ClassificationECOC モデルです。同じ SVM テンプレートが各バイナリ学習器に適用されますが、テンプレートの cell ベクトルを渡すことで各バイナリ学習器のオプションを調整できます。
学習標本のラベルとクラス事後確率を予測します。名前と値の引数 Verbose を使用して、ラベルとクラス事後確率の計算中に診断メッセージを表示します。
[label,~,~,Posterior] = resubPredict(Mdl,Verbose=1);
Predictions from all learners have been computed.
Loss for all observations has been computed.
Computing posterior probabilities...
Mdl.BinaryLoss
ans =
'quadratic'
バイナリ損失の平均が最小となるクラスに観測が割り当てられます。すべてのバイナリ学習器が事後確率を計算しているので、バイナリ損失関数は quadratic になります。
無作為な結果の集合を表示します。
idx = randsample(size(X,1),10,1);
Mdl.ClassNames
ans = 3×1 cell
    {'setosa'    }
    {'versicolor'}
    {'virginica' }
table(Y(idx),label(idx),Posterior(idx,:), ...
    VariableNames=["TrueLabel","PredLabel","Posterior"])
ans = 10×3 table
      TrueLabel         PredLabel                     Posterior
    ______________    ______________    ______________________________________

    {'virginica' }    {'virginica' }     0.0039322      0.003987       0.99208
    {'virginica' }    {'virginica' }      0.017067      0.018263       0.96467
    {'virginica' }    {'virginica' }      0.014948      0.015856        0.9692
    {'versicolor'}    {'versicolor'}    2.2197e-14       0.87318       0.12682
    {'setosa'    }    {'setosa'    }         0.999    0.00025092    0.00074638
    {'versicolor'}    {'virginica' }    2.2195e-14       0.05943       0.94057
    {'versicolor'}    {'versicolor'}    2.2194e-14       0.97001      0.029985
    {'setosa'    }    {'setosa'    }         0.999    0.00024991     0.0007474
    {'versicolor'}    {'versicolor'}     0.0085642       0.98259     0.0088487
    {'setosa'    }    {'setosa'    }         0.999    0.00025013    0.00074717
Posterior の列は Mdl.ClassNames のクラスの順序に対応します。
観測された予測子領域の値のグリッドを定義します。グリッド内の各インスタンスの事後確率を予測します。
xMax = max(X);
xMin = min(X);

x1Pts = linspace(xMin(1),xMax(1));
x2Pts = linspace(xMin(2),xMax(2));
[x1Grid,x2Grid] = meshgrid(x1Pts,x2Pts);

[~,~,~,PosteriorRegion] = predict(Mdl,[x1Grid(:),x2Grid(:)]);
各グリッドの座標では、クラス間の最大クラス事後確率をプロットします。
contourf(x1Grid,x2Grid, ...
        reshape(max(PosteriorRegion,[],2),size(x1Grid,1),size(x1Grid,2)));
h = colorbar;
h.YLabel.String = "Maximum posterior";
h.YLabel.FontSize = 15;

hold on
gh = gscatter(X(:,1),X(:,2),Y,"krk","*xd",8);
gh(2).LineWidth = 2;
gh(3).LineWidth = 2;

title("Iris Petal Measurements and Maximum Posterior")
xlabel("Petal length (cm)")
ylabel("Petal width (cm)")
axis tight
legend(gh,Location="northwest")
hold off
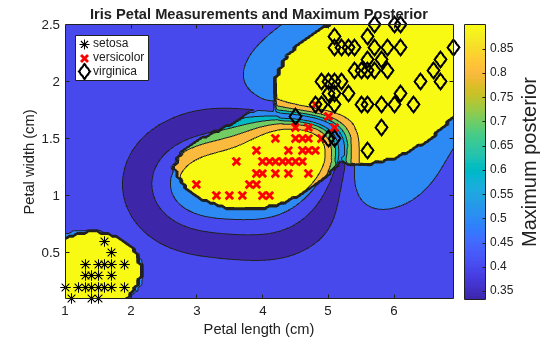
マルチクラス ECOC モデルに学習をさせ、並列計算を使用して事後確率を推定します。
arrhythmia データ セットを読み込みます。応答データ Y を確認して、クラス数を決定します。
load arrhythmia
Y = categorical(Y);
tabulate(Y)
Value Count Percent
1 245 54.20%
2 44 9.73%
3 15 3.32%
4 15 3.32%
5 13 2.88%
6 25 5.53%
7 3 0.66%
8 2 0.44%
9 9 1.99%
10 50 11.06%
14 4 0.88%
15 5 1.11%
16 22 4.87%
K = numel(unique(Y));
複数のクラスはデータに表示されません。また他の多くのクラスは相対的頻度が低くなります。
GentleBoost 法と 50 個の分類木弱学習器を使用するアンサンブル学習テンプレートを指定します。
t = templateEnsemble('GentleBoost',50,'Tree');
t はテンプレート オブジェクトです。ほとんどのプロパティは空 ([]) です。学習時は、すべての空のプロパティに対して既定値が使用されます。
応答変数には多数のクラスが含まれているので、スパースなランダム符号化設計を指定します。
rng(1); % For reproducibility
Coding = designecoc(K,'sparserandom');
並列計算を使用する ECOC モデルを学習させます。事後確率の近似を指定をします。
pool = parpool; % Invokes workersStarting parallel pool (parpool) using the 'Processes' profile ... 31-Jul-2026 08:45:51: Job Running. Waiting for parallel pool workers to connect ... 31-Jul-2026 08:46:52: Job Running. Waiting for parallel pool workers to connect ... 31-Jul-2026 08:47:53: Job Running. Waiting for parallel pool workers to connect ... Connected to parallel pool with 8 workers.
options = statset('UseParallel',"auto");
Mdl = fitcecoc(X,Y,'Learner',t,'Options',options,'Coding',Coding,...
    'FitPosterior',true);
Mdl は ClassificationECOC モデルです。ドット表記を使用してプロパティにアクセスできます。
このプールでは 8 つのワーカーが起動しましたが、ワーカー数はシステムによって異なる可能性があります。
事後確率を推定し、学習データのランダムなサブセットに対して、不整脈がない (クラス 1) と分類される事後確率を表示します。
[~,~,~,posterior] = resubPredict(Mdl);

n = numel(Y);
idx = randsample(n,10,1);
table(idx,Y(idx),posterior(idx,1),...
    'VariableNames',{'ObservationIndex','TrueLabel','PosteriorNoArrythmia'})
ans = 10×3 table
    ObservationIndex    TrueLabel    PosteriorNoArrythmia
    ________________    _________    ____________________

           79              1                0.93817
          248              1                0.94356
          398              10              0.040704
          207              1                0.97791
          340              1                 0.9215
          206              1                0.97983
          345              10              0.015942
          296              2                0.13461
          391              1                0.96233
          406              1                0.95346

	Get insights using Copilot

