このページの内容は最新ではありません。最新版の英語を参照するには、ここをクリックします。
loss
R2026a説明
例
人の行動のデータセットを読み込みます。データをランダムにシャッフルします。
load humanactivity;
n = numel(actid);
rng(123) % For reproducibility
idx = randsample(n,n);
データ セットの詳細については、コマンド ラインで Description を入力してください。
予測子変数と応答変数を定義します。
X = feat(idx,:);
Y = actid(idx);
応答は、次の 5 つのクラスのいずれかになります。座る、立つ、歩く、走る、または踊る。
被験者が移動しているかどうか (actid > 2) を基準に、応答を二分します。
Y = Y > 2;
データセットの後半部分のラベルを反転してドリフトをシミュレートします。
Y(floor(numel(Y)/2):end,:) = ~Y(floor(numel(Y)/2):end,:);
分類用の既定のインクリメンタル ドリフト認識モデルを次のように開始します。
バイナリ分類用の既定のインクリメンタル線形 SVM モデルを作成します。
インクリメンタル線形 SVM モデルをベース学習器として使用して、既定のインクリメンタル ドリフト認識モデルを開始します。
BaseLearner = incrementalClassificationLinear();
idaMdl = incrementalDriftAwareLearner(BaseLearner);
idaMdl は incrementalDriftAwareLearner モデルです。そのプロパティはすべて読み取り専用です。
データ ストリームの作成用に各チャンクの変数の数を事前に割り当てて、分類誤差を格納するための変数も割り当てます。
numObsPerChunk = 50;
nchunk = floor(n/numObsPerChunk);
ce = array2table(zeros(nchunk,3),VariableNames=["Cumulative" "Window" "Loss"]);
PoL = zeros(nchunk,numObsPerChunk); % To store per observation loss values
driftTimes = [];
それぞれ 50 個の観測値の入力チャンクを使用して、データ ストリームをシミュレートします。各反復で次を行います。
updateMetricsを呼び出して、累積性能および観測値ウィンドウ内での性能を測定します。前のインクリメンタル モデルを新しいモデルで上書きして、パフォーマンス メトリクスを追跡します。fitを呼び出して、モデルを入力チャンクに当てはめます。前のインクリメンタル モデルを、入力観測値に当てはめた新しいモデルで上書きします。perObservationLossを呼び出して、データの入力チャンクに含まれる各観測値の分類誤差を計算します。lossを呼び出して、入力チャンクでのモデルの性能を測定します。すべてのパフォーマンス メトリクスを
ceに保存して、インクリメンタル学習中にそれらがどのように進化するかを確認します。idaMdlのMetricsプロパティに累積とウィンドウの分類誤差が格納され、各反復で更新されます。各チャンクの損失値をceの 3 列目に格納します。
for j = 1:nchunk

 ibegin = min(n,numObsPerChunk*(j-1)+1);
 iend   = min(n,numObsPerChunk*j);
 idx = ibegin:iend;

 idaMdl = updateMetrics(idaMdl,X(idx,:),Y(idx));
 idaMdl = fit(idaMdl,X(idx,:),Y(idx));

 PoL(j,:) = perObservationLoss(idaMdl,X(idx,:),Y(idx));
 ce{j,["Cumulative" "Window"]} = idaMdl.Metrics{"ClassificationError",:};
 ce{j,"Loss"} = loss(idaMdl,X(idx,:),Y(idx));
 if idaMdl.DriftDetected
    driftTimes(end+1) = j;
 end
end
関数 updateMetrics は、入力観測値を処理しながらモデルの性能を評価します。指定したメトリクスについて、関数で処理された観測値の累積の測定値と指定したウィンドウにおける測定値が Metrics モデル プロパティに書き込まれます。関数 fit は、データの入力バッチに基づいてベース学習器を更新してドリフトを監視することでモデルを当てはめます。
累積とウィンドウごとの分類誤差をプロットします。ウォームアップ期間と学習期間、およびドリフトが発生した時点をマークします。
h = plot(ce.Variables);
xlim([0 nchunk])
ylim([0 0.07])
ylabel("Classification Error")
xlabel("Iteration")

xline(idaMdl.MetricsWarmupPeriod/numObsPerChunk,"g-.","Warmup Period",LineWidth= 1.5)
xline(idaMdl.TrainingPeriod/numObsPerChunk,"b-.","Training Period",LabelVerticalAlignment="middle",LineWidth= 1.5)
%xline(floor(numel(Y)/2)/numObsPerChunk,"m--","Drift",LabelVerticalAlignment="middle",LineWidth= 1.5)

xline(driftTimes,"m--","Drift",LabelVerticalAlignment="middle",LineWidth=1.5)
legend(h,ce.Properties.VariableNames)
legend(h,Location="best")
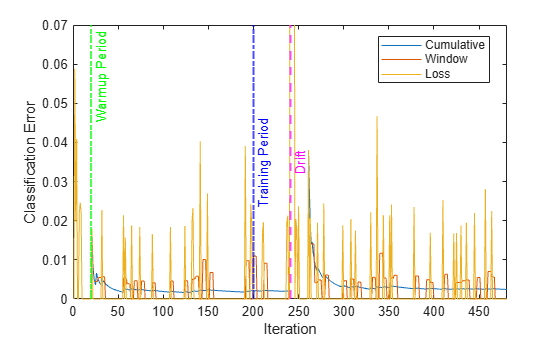
黄色の線は、入力データの各チャンクの分類誤差を表します。loss はメトリクスのウォームアップ期間に依存しないため、すべての反復について分類誤差を測定します。メトリクスのウォームアップ期間後、idaMdl は累積およびウィンドウ メトリクスを追跡します。
観測値ごとの損失をプロットします。
figure()
plot(PoL,'b.');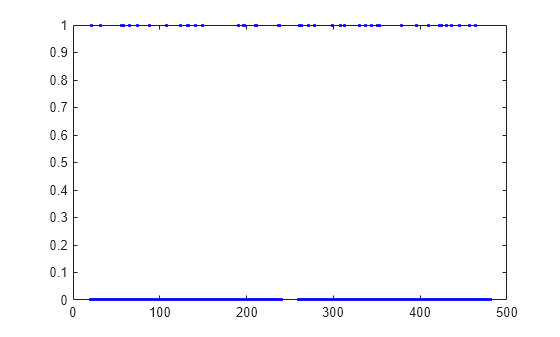
perObservationLoss で、データの入力チャンクに含まれる各観測値の分類誤差が計算されます。
補助関数の HelperRegrGenerator と HelperConceptDriftGenerator をそれぞれ使用して、ランダムな概念データと概念ドリフト発生器を作成します。
concept1 = HelperRegrGenerator(NumFeatures=100,NonZeroFeatures=[1,20,40,50,55], ...
        FeatureCoefficients=[4,5,10,-2,-6],NoiseStd=1.1);
concept2 = HelperRegrGenerator(NumFeatures=100,NonZeroFeatures=[1,20,40,50,55], ...
        FeatureCoefficients=[4,7,10,-1,-5],NoiseStd=1.1);
driftGenerator = HelperConceptDriftGenerator(concept1,concept2,15000,1250);
HelperRegrGenerator は、関数の呼び出しで指定された回帰用の特徴量と特徴量係数を使用してストリーミング データを生成します。この関数は、各ステップで正規分布から予測子を抽出します。その後、特徴量係数と予測子の値を使用して、平均がゼロで指定のノイズ標準偏差をもつ正規分布からランダム ノイズを追加することで応答を計算します。
HelperConceptDriftGenerator は、概念ドリフトを確立します。このオブジェクトでは、シグモイド関数 1./(1+exp(-4*(numobservations-position)./width)) を使用して、データ生成時に 1 つ目のストリームが選択される確率を判定します [3]。この例では、位置の引数が 15000 で、幅の引数が 1250 です。観測値の数が位置の値から幅の半分を引いた値を超えると、データ生成時に 1 つ目のストリームから抽出される確率が低下します。このシグモイド関数により、一方のストリームからもう一方への滑らかな遷移が実現します。幅の値が大きいほど、両方のストリームがほぼ等しい確率で選択される遷移期間が大きいことを示します。
回帰用のインクリメンタル ドリフト認識モデルを次のように構成します。
回帰用のインクリメンタル線形モデルを作成します。平均絶対偏差 (MAD) を追跡して、モデルの性能を測定します。新しい各観測値の絶対誤差を測定する無名関数を作成します。名前
MeanAbsoluteErrorとそれに対応する関数を含む構造体配列を作成します。メトリクスのウォームアップ期間を観測値 1000 個に指定します。メトリクス ウィンドウ サイズを観測値 500 個に指定します。連続データ用のインクリメンタルな概念ドリフト検出器を開始します。移動平均による Hoeffding 境界のドリフト検出法 (HDDMA) を使用します。
インクリメンタル線形モデルと概念ドリフト検出器を使用して、インクリメンタル ドリフト認識モデルをインスタンス化します。学習期間を 1000 個の観測値として指定します。
maefcn = @(z,zfit,w)(abs(z - zfit)); % Mean absolute deviation function
maemetric = struct(MeanAbsoluteError=maefcn);

baseMdl = incrementalRegressionLinear(MetricsWarmupPeriod=1000,MetricsWindowSize=400,Metrics=maemetric,EstimationPeriod=0);
dd = incrementalConceptDriftDetector("hddma",Alternative="greater",InputType="continuous");
idaMdl = incrementalDriftAwareLearner(baseMdl,DriftDetector=dd,TrainingPeriod=2000);
20 個の観測値を含む初期標本を生成し、その初期標本に当てはめて応答を予測するようにモデルを構成します。
initobs = 20;
rng(1234); % For reproducibility
[driftGenerator,X,Y] = hgenerate(driftGenerator,initobs);
idaMdl = fit(idaMdl,X,Y);
データ ストリームの作成用に各チャンクの変数の数と反復回数を事前に割り当てて、分類誤差、ドリフト ステータス、およびドリフト時間を格納するための変数も割り当てます。
numObsPerChunk = 50;
numIterations = 500;

mae = array2table(zeros(numIterations,3),VariableNames=["Cumulative" "Window" "Chunk"]);
PoL = zeros(numIterations,numObsPerChunk); % Per observation loss values

driftTimes = [];
dstatus = zeros(numIterations,1);
statusname = strings(numIterations,1);
それぞれ 50 個の観測値の入力チャンクを使用してデータ ストリームをシミュレートし、インクリメンタル ドリフト認識学習を実行します。各反復で次を行います。
予測子データとラベルをシミュレートし、補助関数
hgenerateを使用してドリフト発生器を更新します。updateMetricsを呼び出して、データの入力チャンクの累積メトリクスとウィンドウ メトリクスを計算します。前のインクリメンタル モデルを、前のメトリクスを上書きするように当てはめた新しいモデルで上書きします。lossを呼び出して、データの入力チャンクの MAD を計算します。累積メトリクスおよびウィンドウ メトリクスでは、カスタム損失が各観測値の損失を返す必要がありますが、lossではチャンク全体での損失が必要です。絶対偏差の平均を計算します。perObservationLossを呼び出して、観測値ごとの回帰誤差を計算します。fitを呼び出して、データの入力チャンクにインクリメンタル モデルを当てはめます。累積、ウィンドウ、およびチャンクのメトリクスと観測値ごとの損失を保存して、インクリメンタル学習中にそれらがどのように進化するかを確認します。
for j = 1:numIterations

  % Generate data
    [driftGenerator,X,Y] = hgenerate(driftGenerator,numObsPerChunk);

  % Perform incremental fitting and store performance metrics
    idaMdl = updateMetrics(idaMdl,X,Y);
    PoL(j,:) = perObservationLoss(idaMdl,X,Y,'LossFun',@(x,y,w)(maefcn(x,y)));
    mae{j,1:2} = idaMdl.Metrics{"MeanAbsoluteError",:};
    mae{j,3} = loss(idaMdl,X,Y,LossFun=@(x,y,w)mean(maefcn(x,y,w)));
    idaMdl = fit(idaMdl,X,Y);

    statusname(j) = string(idaMdl.DriftStatus);
    if idaMdl.DriftDetected
       driftTimes(end+1) = j;
       dstatus(j) = 2;
    elseif idaMdl.WarningDetected
       dstatus(j) = 1;
    else
       dstatus(j) = 0;
    end

end
idaMdl は、ストリーム内のすべてのデータで学習させた incrementalDriftAwareLearner モデル オブジェクトです。インクリメンタル学習中およびモデルがウォームになった後、updateMetrics は入力観測値でのモデルの性能をチェックし、関数 fit はモデルをその観測値に当てはめます。
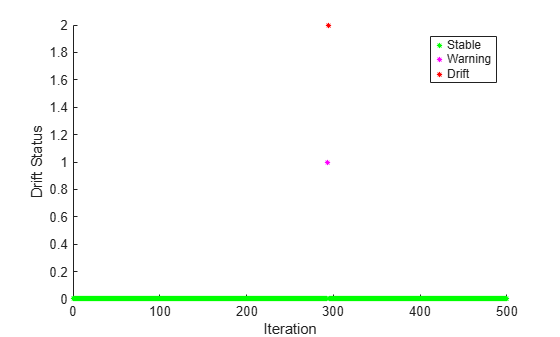
ドリフト ステータスをプロットします。
gscatter(1:numIterations,dstatus,statusname,'gmr','*',4,'on',"Iteration","Drift Status")
xlim([0 numIterations])
パフォーマンス メトリクスをプロットして、インクリメンタル学習中にそれらがどのように進化したかを確認します。
figure
h = plot(mae.Variables);
xlim([0 numIterations])
ylim([0 4])
ylabel("Mean Absolute Deviation")
xlabel("Iteration")

xline(idaMdl.MetricsWarmupPeriod/numObsPerChunk,"g-.","Warmup Period",LineWidth= 1.5)
xline(idaMdl.TrainingPeriod/numObsPerChunk,"b-.","Training Period",LabelVerticalAlignment="middle",LineWidth= 1.5)
xline(driftTimes,"m--","Drift",LabelVerticalAlignment="middle",LineWidth=1.5)
legend(h,mae.Properties.VariableNames)
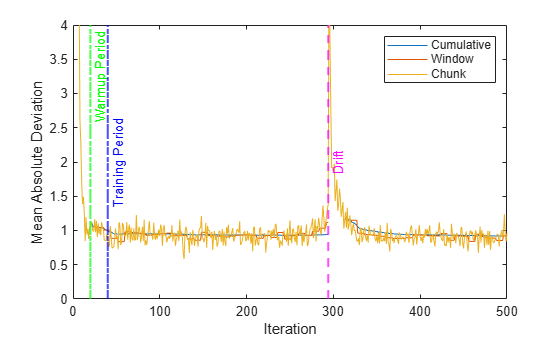
プロットは次のことを示しています。
updateMetricsは、パフォーマンス メトリクスをメトリクスのウォームアップ期間後にのみ計算します。updateMetricsは、累積メトリクスを各反復中に計算します。updateMetricsは、ウィンドウ メトリクスを 400 個の観測値の処理後に計算します。idaMdlが観測値の予測のためにインクリメンタル学習の初めから構成されたため、lossはデータの入力チャンクごとに MAD を計算できます。
観測値ごとの損失をプロットします。
figure()
plot(PoL,'b.');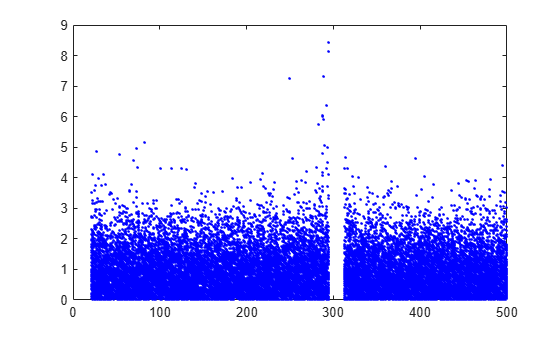
perObservationLoss で、メトリクスのウォームアップ期間後にデータの入力チャンクに含まれる各観測値の分類誤差が計算されます。
入力引数
名前と値の引数
参照
バージョン履歴
R2022b で導入

