このページの内容は最新ではありません。最新版の英語を参照するには、ここをクリックします。
updateMetricsAndFit
R2026a説明
ストリーミング データが与えられると、updateMetricsAndFit は、最初に、入力データの updateMetrics を呼び出して、カーネル回帰用 (incrementalRegressionKernel オブジェクト) またはバイナリ カーネル分類用 (incrementalClassificationKernel オブジェクト) に構成されたインクリメンタル学習モデルのパフォーマンスを評価します。次に、updateMetricsAndFit は、fit を呼び出して、モデルをそのデータに当てはめます。言い換えると、updateMetricsAndFit は "逐次予測評価" を実行します。データの各入力チャンクをテスト セットとして扱い、累積的に測定されたパフォーマンス メトリクスと指定したウィンドウにおけるパフォーマンス メトリクスを追跡します[1]。
updateMetricsAndFit は、モデルのパフォーマンス メトリクスを更新し、データの各チャンクでモデルに学習させる簡単な方法を提供します。また、updateMetrics を呼び出してから fit を呼び出して、個別に操作を実行することもできます。これにより柔軟性を高めることができます (たとえば、データのチャンクでのパフォーマンスに基づいて、モデルに学習させる必要があるかどうかを決定できます)。
Mdl = updateMetricsAndFit(Mdl,X,Y)Mdl を返します。これは、入力インクリメンタル学習モデル Mdl であり、次の変更が行われます。
updateMetricsAndFitは、入力予測子と応答データ (それぞれXとY) のモデル パフォーマンスを測定します。入力モデルが "ウォーム" (Mdl.IsWarmがtrue) の場合、updateMetricsAndFitは以前に計算されたメトリクスを上書きし、Metricsプロパティに新しい値を保存します。それ以外の場合、updateMetricsAndFitは代わりにMetricsにNaN値を保存します。updateMetricsAndFitは、次の手順に従って、変更されたモデルを入力データに当てはめます。
入力モデルと出力モデルのデータ型は同じです。
例
incrementalClassificationKernel を呼び出して、バイナリ分類用のインクリメンタル カーネル モデルを直接作成します。updateMetricsAndFit を使用して、モデルの性能を追跡してモデルをストリーミング データに当てはめる操作を 1 回の呼び出しで行います。
バイナリ分類用の既定のインクリメンタル カーネル モデルを作成します。
Mdl = incrementalClassificationKernel()
Mdl =
  incrementalClassificationKernel

                    IsWarm: 0
                   Metrics: [1×2 table]
                ClassNames: [1×0 double]
            ScoreTransform: 'none'
    NumExpansionDimensions: 0
               KernelScale: 1


  Properties, Methods
Mdl は incrementalClassificationKernel モデル オブジェクトです。そのプロパティはすべて読み取り専用です。
Mdl は、他の演算の実行に使用する前に、データに当てはめなければなりません。
人の行動のデータ セットを読み込みます。データをランダムにシャッフルします。
load humanactivity
n = numel(actid);
rng(1) % For reproducibility
idx = randsample(n,n);
X = feat(idx,:);
Y = actid(idx);
データ セットの詳細については、コマンド ラインで Description を入力してください。
応答は、次の 5 つのクラスのいずれかになります。座る、立つ、歩く、走る、または踊る。被験者が移動しているかどうか (actid > 2) を基準に、応答を二分します。
Y = Y > 2;
関数 updateMetricsAndFit を使用して、インクリメンタル モデルを学習データに当てはめます。各反復で次を行います。
50 個の観測値のチャンクを処理して、データ ストリームのシミュレーションを実行します。
前のインクリメンタル モデルを、入力観測値に当てはめた新しいモデルで上書きします。
累積メトリクス、ウィンドウ メトリクス、および学習観測値の数を保存し、インクリメンタル学習中にそれらがどのように進化するかを確認します。
% Preallocation
numObsPerChunk = 50;
nchunk = floor(n/numObsPerChunk);
ce = array2table(zeros(nchunk,2),VariableNames=["Cumulative","Window"]);
numtrainobs = [zeros(nchunk,1)];

% Incremental fitting
for j = 1:nchunk
    ibegin = min(n,numObsPerChunk*(j-1) + 1);
    iend   = min(n,numObsPerChunk*j);
    idx = ibegin:iend;
    Mdl = updateMetricsAndFit(Mdl,X(idx,:),Y(idx));
    ce{j,:} = Mdl.Metrics{"ClassificationError",:};
    numtrainobs(j) = Mdl.NumTrainingObservations;
end
Mdl は、ストリーム内のすべてのデータで学習させた incrementalClassificationKernel モデル オブジェクトです。インクリメンタル学習中およびモデルがウォームアップされた後、updateMetricsAndFit は入力観測値でモデルの性能をチェックし、モデルをその観測値に当てはめます。
観測値の数とパフォーマンス メトリクスが学習中にどのように進化するかを確認するには、それらを別々のタイルにプロットします。
t = tiledlayout(2,1);
nexttile
plot(numtrainobs)
ylabel("Number of Training Observations")
xlim([0 nchunk])
nexttile
plot(ce.Variables)
xlim([0 nchunk])
ylabel("Classification Error")
xline((Mdl.EstimationPeriod + Mdl.MetricsWarmupPeriod)/numObsPerChunk,"--");
legend(ce.Properties.VariableNames)
xlabel(t,"Iteration")
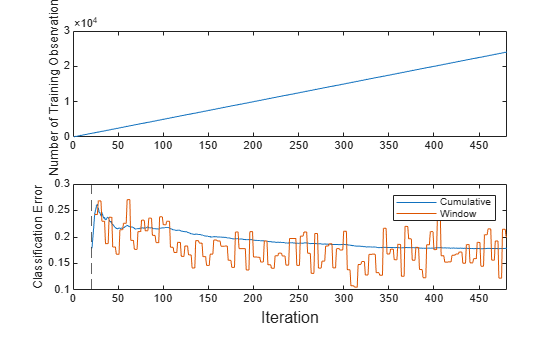
プロットは、updateMetricsAndFit が次を行うことを示しています。
モデルをインクリメンタル学習のすべての反復で当てはめます。
パフォーマンス メトリクスをメトリクスのウォームアップ期間後にのみ計算します。
累積メトリクスを各反復中に計算します。
ウィンドウ メトリクスを 200 個の観測値 (4 回の反復) の処理後に計算します。
fitrkernel を使用してカーネル回帰モデルに学習させ、incrementalLearner を使用してインクリメンタル学習器に変換します。updateMetricsAndFit を使用して、モデルの性能を追跡してモデルをストリーミング データに当てはめる操作を 1 回の呼び出しで行います。updateMetricsAndFit を呼び出すときに観測値の重みを指定します。
データの読み込みと前処理
2015 年のニューヨーク市住宅データ セットを読み込み、データをシャッフルします。このデータの詳細については、NYC Open Data を参照してください。
load NYCHousing2015
rng(1) % For reproducibility
n = size(NYCHousing2015,1);
idxshuff = randsample(n,n);
NYCHousing2015 = NYCHousing2015(idxshuff,:);
マンハッタンから収集されたデータ (BOROUGH = 1) が、品質を 2 倍にする新しい方法を使用して収集されたとします。マンハッタンから収集した観測値に 2 を割り当て、その他すべての観測値に 1 を割り当てる重み変数を作成します。
n = size(NYCHousing2015,1);
NYCHousing2015.W = ones(n,1) + (NYCHousing2015.BOROUGH == 1);
table から応答変数 SALEPRICE を抽出します。数値安定性を得るために、SALEPRICE を 1e6 の尺度でスケールします。
Y = NYCHousing2015.SALEPRICE/1e6;
NYCHousing2015.SALEPRICE = [];
この例の計算コストを削減するために、254 個のカテゴリをもつカテゴリカル変数が含まれている NEIGHBORHOOD 列を削除します。
NYCHousing2015.NEIGHBORHOOD = [];
他のカテゴリカル予測子からダミー変数メトリクスを作成します。
catvars = ["BOROUGH","BUILDINGCLASSCATEGORY"];
dumvarstbl = varfun(@(x)dummyvar(categorical(x)),NYCHousing2015, ...
    InputVariables=catvars);
dumvarmat = table2array(dumvarstbl);
NYCHousing2015(:,catvars) = [];
テーブル内の他のすべての数値変数を売価の予測子として扱います。ダミー変数の行列を予測子データの残りに連結します。
idxnum = varfun(@isnumeric,NYCHousing2015,OutputFormat="uniform");
X = [dumvarmat NYCHousing2015{:,idxnum}];
カーネル回帰モデルの学習
カーネル回帰モデルを、データの半分から取った無作為標本に当てはめます。
idxtt = randsample([true false],n,true);
TTMdl = fitrkernel(X(idxtt,:),Y(idxtt),Weights=NYCHousing2015.W(idxtt))
TTMdl =
  RegressionKernel
              ResponseName: 'Y'
                   Learner: 'svm'
    NumExpansionDimensions: 2048
               KernelScale: 1
                    Lambda: 2.1977e-05
             BoxConstraint: 1
                   Epsilon: 0.0547


  Properties, Methods
TTMdl は従来式の学習済みカーネル回帰モデルを表す RegressionKernel モデル オブジェクトです。
学習済みモデルの変換
従来式の学習済みカーネル回帰モデルをインクリメンタル学習用のモデルに変換します。
IncrementalMdl = incrementalLearner(TTMdl)
IncrementalMdl =
  incrementalRegressionKernel

                    IsWarm: 1
                   Metrics: [1×2 table]
         ResponseTransform: 'none'
    NumExpansionDimensions: 2048
               KernelScale: 1


  Properties, Methods
IncrementalMdl は incrementalRegressionKernel モデル オブジェクトです。そのプロパティはすべて読み取り専用です。
パフォーマンス メトリクスの追跡とモデルの当てはめ
関数 updateMetricsAndFit を使用して、残りのデータに対してインクリメンタル学習を実行します。各反復で次を行います。
500 個の観測値のチャンクを処理して、データ ストリームのシミュレーションを実行します。
updateMetricsAndFitを呼び出し、観測値の入力チャンクを所与として、モデルのイプシロン不感応損失の累積とウィンドウを更新し、モデルをデータに当てはめます。前のインクリメンタル モデルを新しいモデルで上書きします。観測値の重みを指定します。損失を保存します。
% Preallocation
idxil = ~idxtt;
nil = sum(idxil);
numObsPerChunk = 500;
nchunk = floor(nil/numObsPerChunk);
ei = array2table(zeros(nchunk,2),VariableNames=["Cumulative","Window"]);
Xil = X(idxil,:);
Yil = Y(idxil);
Wil = NYCHousing2015.W(idxil);

% Incremental fitting
for j = 1:nchunk
    ibegin = min(nil,numObsPerChunk*(j-1) + 1);
    iend   = min(nil,numObsPerChunk*j);
    idx = ibegin:iend;
    IncrementalMdl = updateMetricsAndFit(IncrementalMdl,Xil(idx,:),Yil(idx), ...
        Weights=Wil(idx));
    ei{j,:} = IncrementalMdl.Metrics{"EpsilonInsensitiveLoss",:};
end
IncrementalMdl は、ストリーム内のすべてのデータで学習させた incrementalRegressionKernel モデル オブジェクトです。
パフォーマンス メトリクスのトレース プロットをプロットします。
plot(ei.Variables)
xlim([0 nchunk])
ylabel("Epsilon Insensitive Loss")
legend(ei.Properties.VariableNames)
xlabel("Iteration")
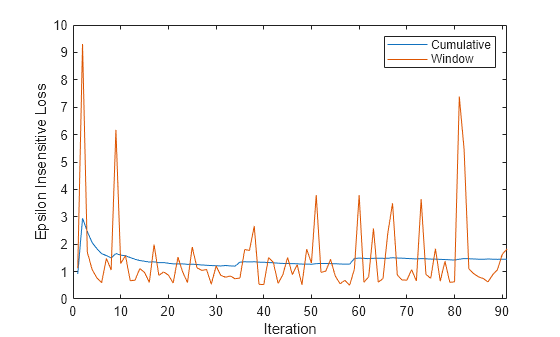
累積の損失は各反復 (500 個の観測値のチャンク) ごとに徐々に変化しますが、ウィンドウの損失には急な変動があります。メトリクス ウィンドウの既定値は 200 なので、updateMetricsAndFit は 500 個の観測値のチャンクごとに最新の 200 個の観測値に基づいて性能を測定します。

