このページの内容は最新ではありません。最新版の英語を参照するには、ここをクリックします。
複数の GPU での MATLAB 関数の実行
R2026aこの例では、MATLAB® コードを複数の GPU で並列に実行する方法を説明します。まずローカル マシンで実行し、次にクラスターにスケール アップします。この例では、サンプル問題としてロジスティック マップ (人口の増加をモデル化した方程式) を使用します。
MATLAB のますます多くの機能で、マルチ GPU サポートなど、追加コーディングの一切不要な自動並列サポートが提供されています。詳細については、自動並列サポートを使用した MATLAB 関数の実行を参照してください。たとえば、関数 trainnet (Deep Learning Toolbox) はニューラル ネットワークの学習用のマルチ GPU サポートを提供しています。詳細については、並列処理、GPU、およびクラウドによる深層学習のスケール アップ (Deep Learning Toolbox)を参照してください。
単一の GPU の使用
単一の GPU 上で計算を実行するには、gpuArrayオブジェクトを GPU 対応 MATLAB 関数の入力として使用します。GPU 対応関数の詳細については、GPU での MATLAB 関数の実行を参照してください。
増加率 r と人口 x を定義する GPU 配列を作成します。gpuArray オブジェクトの作成の詳細については、GPU での配列の確立を参照してください。
N = 200000;
r = gpuArray.linspace(0,4,N);
x = rand(1,N,"gpuArray");
単純なアルゴリズムを使用してロジスティック マップを反復します。このアルゴリズムでは GPU 対応の演算子を gpuArray 入力データに使用しているため、計算は GPU で実行されます。
numIterations = 1000;
for n=1:numIterations
    x = r.*x.*(1-x);
end
計算の完了後、人口に対して増加率をプロットします。
plot(r,x,".",MarkerSize=1)
xlabel("Growth Rate")
ylabel("Population")

さらに高いパフォーマンスが必要な場合、GPU 配列はいくつかのオプションをサポートしています。そのリストについては、関数gpuArrayのページを参照してください。たとえば、この例のアルゴリズムは GPU 配列の要素単位の演算のみを行っているため、関数arrayfunを使用して GPU 用にそれらの演算をプリコンパイルできます。
parfor による複数の GPU の使用
parforループを使用して for ループの反復を複数の並列ワーカーに分散できます。計算で GPU 対応関数を使用している場合、計算はワーカーの GPU で実行されます。たとえば、モンテカルロ法を使用して人口の変化をランダムにシミュレートする場合、シミュレーションは parfor ループを使用して複数の GPU で並列に計算されます。
parpoolを使用して、使用可能な GPU と同じ数のワーカーをもつ並列プールを作成します。使用可能な GPU の数を調べるには、関数gpuDeviceCountを使用します。既定で、MATLAB は最高のパフォーマンスを得るために各ワーカーに異なる GPU を割り当てます。並列プールにおける GPU の選択の詳細については、並列プールにおける複数の GPU の使用を参照してください。
numGPUs = gpuDeviceCount("available");
parpool(numGPUs);
Starting parallel pool (parpool) using the 'Processes' profile ... Connected to parallel pool with 2 workers.
シミュレーション回数を定義し、各シミュレーションの人口ベクトルを格納する配列を GPU 内に作成します。
numSimulations = 100;
X = zeros(numSimulations,N,"gpuArray");
parfor ループを使用して、プール内のワーカーにシミュレーションを分散します。ループ内のコードにより初期の人口のランダムな gpuArray が作成され、それに対してロジスティック マップが反復されます。このコードは GPU 対応の演算子を gpuArray 入力データに使用するため、計算は自動的にワーカーの GPU で実行されます。
parfor i = 1:numSimulations
    X(i,:) = rand(1,N,"gpuArray");
    for n=1:numIterations
        X(i,:) = r.*X(i,:).*(1-X(i,:));
    end
end
計算の完了後、すべてのシミュレーションの結果をプロットします。それぞれの色は異なるシミュレーションを表します。
figure
plot(r,X,".",MarkerSize=1)
xlabel("Growth Rate")
ylabel("Population")
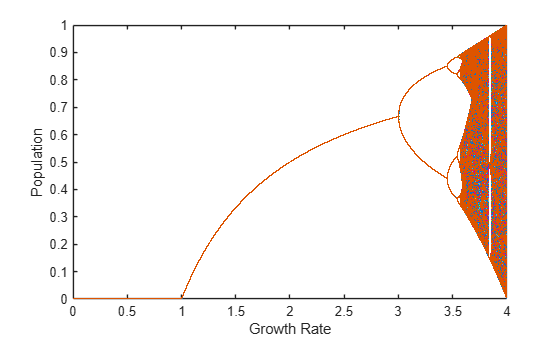
既定の設定では、プロセス ワーカーの並列プールがparpoolで起動されます。プロセス ワーカーでコードを並列実行すると、データが各ワーカーにコピーされ、GPU 配列を処理するときに大量の GPU メモリが使用されることがよくあります。これに対し、スレッド ワーカーではメモリを共有できます。メモリ使用量を削減してデータ転送コストを低減するには、parpool("Threads") を呼び出してスレッド ワーカーの並列プールを使用します。スレッド ワーカーは、プロセス ワーカーで使用できる関数のサブセットのみをサポートしています。詳細については、スレッドベースの環境またはプロセスベースの環境の選択を参照してください。
計算をさらに細かく制御する必要がある場合は、より高度な並列機能を使用できます。たとえば、parallel.pool.DataQueueを使用して計算中にワーカーからデータを送信できます。例は、parfor を使用したパラメーター スイープ中のプロットを参照してください。
再現可能な一連の乱数を発生させる場合は、ワーカーの GPU での乱数発生を制御できます。詳細については、GPU 上の乱数ストリームを参照してください。
parfeval による複数 GPU の非同期の使用
parfevalを使用すると、並列プール ワーカーで計算を非同期で実行できます。計算で GPU 対応関数を使用している場合、計算はワーカーの GPU で実行されます。たとえば、複数の GPU 上でモンテカルロ シミュレーションを非同期で実行することができます。
ワーカーでの計算完了後の計算結果を保持するために、Future オブジェクトを使用します。各シミュレーションの結果用に Future オブジェクトの配列を事前に割り当てます。
f(numSimulations) = parallel.FevalFuture;
parfeval を使用して計算を実行するには、それらを関数内に配置しなければなりません。単一のシミュレーションのコードを含む関数を定義します。
function x = myParallelFcn(r)
    N = 200000;
    x = gpuArray.rand(1,N);
    numIterations = 1000;
    for n=1:numIterations
        x = r.*x.*(1-x);
    end
end
for ループを使用してシミュレーションをループし、parfeval を使用して並列プール内のワーカーでシミュレーションを非同期で実行します。myParallelFcn は GPU 対応関数を gpuArray に使用するため、それらの関数はワーカーの GPU で実行されます。parfeval は計算を非同期で実行するため、MATLAB はブロックされず、計算の実行中も作業を続行できます。
for i=1:numSimulations
    f(i) = parfeval(@myParallelFcn,1,r);
end
結果の準備ができたときにそれを parfeval から収集するには、Future オブジェクトに対してfetchOutputsまたはfetchNextを使用できます。また、afterEachまたはafterAllを使用して、結果の準備ができたとき、その結果に対し自動的に関数を呼び出すこともできます。たとえば、各シミュレーションの完了直後にその結果をプロットするには、Future オブジェクトに対して afterEach を使用します。それぞれの色は異なるシミュレーションを表します。
figure
xlabel("Growth Rate")
ylabel("Population")
hold on
afterEach(f,@(x) plot(r,x,".",MarkerSize=1),0);
wait(f)
hold off

クラスターでの複数の GPU の使用
複数の GPU をもつクラスターを使用できる場合は、計算をスケール アップすることができます。関数parpoolを使用して、クラスター上の並列プールを起動します。これにより、parfor ループ、parfeval などの並列機能がクラスター ワーカーで実行されます。計算で gpuArray 入力データに GPU 対応関数を使用する場合、それらの関数はクラスター ワーカーの GPU で実行されます。クラスター機能は、プロセスベースの環境でのみサポートされています。クラスター内のリモート GPU でコードを実行する方法を示す例については、Work with Remote GPUsを参照してください。クラスター上での並列機能の実行の詳細については、デスクトップからクラスターへのスケール アップを参照してください。
高速マルチノード GPU 通信の高度なサポート
MATLAB® の一部のマルチ GPU 機能 (関数 trainnet など) は、高速相互接続で直接通信して高い性能を実現できるように最適化されています。
ハードウェアが適切に接続されている場合、複数の GPU 間のデータ転送において、利用可能であれば NVLink などの高速ピアツーピア通信が使用されます。
Infiniband などのマシン間の高速相互接続または GPUDirect RDMA などの異なるマシン上の GPU 間の高速相互接続を使用する Linux® 計算クラスターを使用している場合、MATLAB の高速マルチノード サポートを活用できる場合があります。環境変数 PARALLEL_SERVER_FAST_MULTINODE_GPU_COMMUNICATION を 1 に設定して、プール内のすべてのワーカーでこのサポートを有効にします。この環境変数はクラスター プロファイル マネージャーで設定します。
この機能は、GPU 通信用の NVIDIA NCCL ライブラリの一部です。これを構成するには、追加の環境変数 (特に NCCL_SOCKET_IFNAME) を設定して、ネットワーク インターフェイス プロトコルを定義しなければなりません。詳細については、NCCL のドキュメンテーション、特に NCCL 環境変数のセクションを参照してください。
参考
gpuArray | gpuDevice | parpool | parfor | parfeval | fetchOutputs | afterEach
トピック
- GPU での MATLAB 関数の実行
- Work with Remote GPUs
- デスクトップからクラスターへのスケール アップ
- 並列処理、GPU、およびクラウドによる深層学習のスケール アップ (Deep Learning Toolbox)
- MATLAB での GPU 計算

