fitlda
R2026b潜在的ディリクレ配分 (LDA) モデルの当てはめ
説明
潜在的ディリクレ配分 (LDA) モデルは、文書のコレクションに内在するトピックを発見し、トピック内の単語の確率を推測するトピック モデルです。bag-of-n-grams モデルを使用して当てはめられたモデルの場合、ソフトウェアは n-gram を個々の単語として扱います。
例
この例の結果を再現するために、rng を 'default' に設定します。
rng('default')サンプル データを読み込みます。ファイル sonnetsPreprocessed.txt には、シェイクスピアのソネット集の前処理されたバージョンが格納されています。ファイルには、1 行に 1 つのソネットが含まれ、単語がスペースで区切られています。sonnetsPreprocessed.txt からテキストを抽出し、テキストを改行文字で文書に分割した後、文書をトークン化します。
filename = "sonnetsPreprocessed.txt";
str = extractFileText(filename);
textData = split(str,newline);
documents = tokenizedDocument(textData);
bagOfWords を使用して bag-of-words モデルを作成します。
bag = bagOfWords(documents)
bag =
  bagOfWords with properties:

          Counts: [154×3092 double]
      Vocabulary: ["fairest"    "creatures"    "desire"    "increase"    "thereby"    "beautys"    "rose"    "might"    "never"    "die"    "riper"    "time"    "decease"    "tender"    "heir"    "bear"    "memory"    "thou"    "contracted"    …    ]
        NumWords: 3092
    NumDocuments: 154
トピック数 4 の LDA モデルを当てはめます。
numTopics = 4;
mdl = fitlda(bag,numTopics)
Initial topic assignments sampled in 0.263378 seconds.
=====================================================================================
| Iteration  |  Time per  |  Relative  |  Training  |     Topic     |     Topic     |
|            | iteration  | change in  | perplexity | concentration | concentration |
|            | (seconds)  |   log(L)   |            |               |   iterations  |
=====================================================================================
|          0 |       0.17 |            |  1.215e+03 |         1.000 |             0 |
|          1 |       0.02 | 1.0482e-02 |  1.128e+03 |         1.000 |             0 |
|          2 |       0.02 | 1.7190e-03 |  1.115e+03 |         1.000 |             0 |
|          3 |       0.01 | 4.3796e-04 |  1.118e+03 |         1.000 |             0 |
|          4 |       0.01 | 9.4193e-04 |  1.111e+03 |         1.000 |             0 |
|          5 |       0.01 | 3.7079e-04 |  1.108e+03 |         1.000 |             0 |
|          6 |       0.01 | 9.5777e-05 |  1.107e+03 |         1.000 |             0 |
=====================================================================================
mdl =
  ldaModel with properties:

                     NumTopics: 4
             WordConcentration: 1
            TopicConcentration: 1
      CorpusTopicProbabilities: [0.2500 0.2500 0.2500 0.2500]
    DocumentTopicProbabilities: [154×4 double]
        TopicWordProbabilities: [3092×4 double]
                    Vocabulary: ["fairest"    "creatures"    "desire"    "increase"    "thereby"    "beautys"    "rose"    "might"    "never"    "die"    "riper"    "time"    "decease"    "tender"    "heir"    "bear"    "memory"    "thou"    …    ]
                    TopicOrder: 'initial-fit-probability'
                       FitInfo: [1×1 struct]
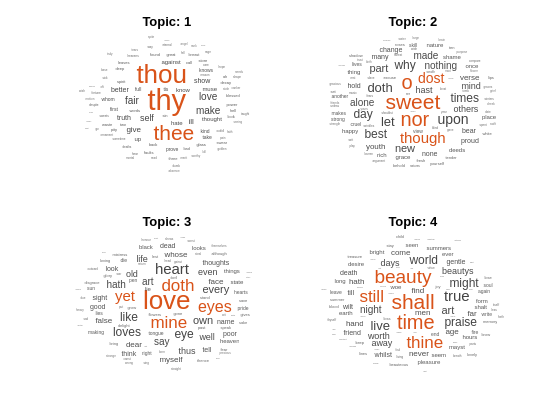
ワード クラウドを使用してトピックを可視化します。
figure
for topicIdx = 1:4
    subplot(2,2,topicIdx)
    wordcloud(mdl,topicIdx);
    title("Topic: " + topicIdx)
end
LDA モデルを単語カウント行列で表される文書のコレクションに当てはめます。
この例の結果を再現するために、rng を 'default' に設定します。
rng('default')サンプル データを読み込みます。sonnetsCounts.mat には、シェイクスピアのソネット集の前処理されたバージョンの単語カウントと対応するボキャブラリの行列が格納されています。値 counts(i,j) は、ボキャブラリの j 番目の単語が i 番目の文書に出現する回数に対応します。
load sonnetsCounts.mat
size(counts)
ans = 1×2
154 3092
トピック数 7 の LDA モデルを当てはめます。詳細出力を表示しないようにするには、'Verbose' を 0 に設定します。
numTopics = 7;
mdl = fitlda(counts,numTopics,'Verbose',0);
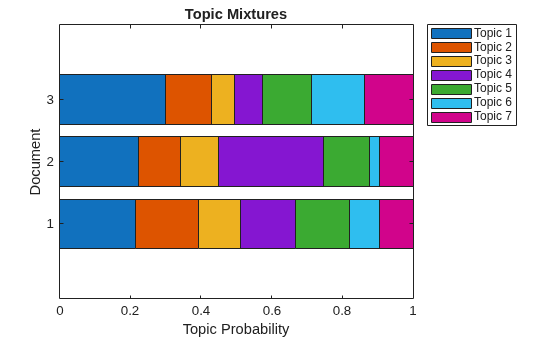
積み上げ棒グラフを使用して、複数のトピックの混合率を可視化します。最初の 3 つの入力文書のトピックの混合率を可視化します。
topicMixtures = transform(mdl,counts(1:3,:));
figure
barh(topicMixtures,'stacked')
xlim([0 1])
title("Topic Mixtures")
xlabel("Topic Probability")
ylabel("Document")
legend("Topic "+ string(1:numTopics),'Location','northeastoutside')
この例の結果を再現するために、rng を 'default' に設定します。
rng('default')サンプル データを読み込みます。ファイル sonnetsPreprocessed.txt には、シェイクスピアのソネット集の前処理されたバージョンが格納されています。ファイルには、1 行に 1 つのソネットが含まれ、単語がスペースで区切られています。sonnetsPreprocessed.txt からテキストを抽出し、テキストを改行文字で文書に分割した後、文書をトークン化します。
filename = "sonnetsPreprocessed.txt";
str = extractFileText(filename);
textData = split(str,newline);
documents = tokenizedDocument(textData);
bagOfWords を使用して bag-of-words モデルを作成します。
bag = bagOfWords(documents)
bag =
  bagOfWords with properties:

          Counts: [154×3092 double]
      Vocabulary: ["fairest"    "creatures"    "desire"    "increase"    "thereby"    "beautys"    "rose"    "might"    "never"    "die"    "riper"    "time"    "decease"    "tender"    "heir"    "bear"    "memory"    "thou"    "contracted"    …    ]
        NumWords: 3092
    NumDocuments: 154
トピック数 20 の LDA モデルを当てはめます。
numTopics = 20;
mdl = fitlda(bag,numTopics)
Initial topic assignments sampled in 0.513255 seconds.
=====================================================================================
| Iteration  |  Time per  |  Relative  |  Training  |     Topic     |     Topic     |
|            | iteration  | change in  | perplexity | concentration | concentration |
|            | (seconds)  |   log(L)   |            |               |   iterations  |
=====================================================================================
|          0 |       0.04 |            |  1.159e+03 |         5.000 |             0 |
|          1 |       0.05 | 5.4884e-02 |  8.028e+02 |         5.000 |             0 |
|          2 |       0.04 | 4.7400e-03 |  7.778e+02 |         5.000 |             0 |
|          3 |       0.04 | 3.4597e-03 |  7.602e+02 |         5.000 |             0 |
|          4 |       0.03 | 3.4662e-03 |  7.430e+02 |         5.000 |             0 |
|          5 |       0.03 | 2.9259e-03 |  7.288e+02 |         5.000 |             0 |
|          6 |       0.03 | 6.4180e-05 |  7.291e+02 |         5.000 |             0 |
=====================================================================================
mdl =
  ldaModel with properties:

                     NumTopics: 20
             WordConcentration: 1
            TopicConcentration: 5
      CorpusTopicProbabilities: [0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500 0.0500]
    DocumentTopicProbabilities: [154×20 double]
        TopicWordProbabilities: [3092×20 double]
                    Vocabulary: ["fairest"    "creatures"    "desire"    "increase"    "thereby"    "beautys"    "rose"    "might"    "never"    "die"    "riper"    "time"    "decease"    "tender"    "heir"    "bear"    "memory"    "thou"    …    ]
                    TopicOrder: 'initial-fit-probability'
                       FitInfo: [1×1 struct]
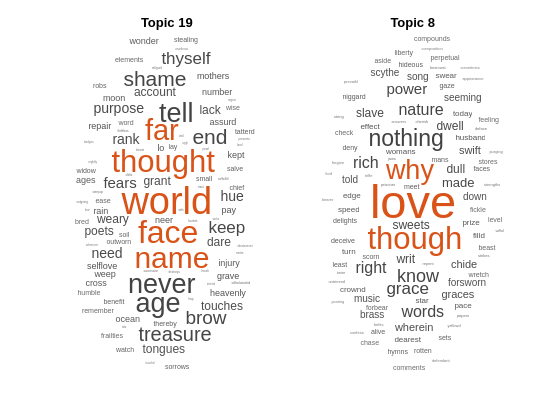
新しい文書の配列の上位トピックを予測します。
newDocuments = tokenizedDocument([
    "what's in a name? a rose by any other name would smell as sweet."
    "if music be the food of love, play on."]);
topicIdx = predict(mdl,newDocuments)
topicIdx = 2×1
19
8
ワード クラウドを使用して、予測されたトピックを可視化します。
figure
subplot(1,2,1)
wordcloud(mdl,topicIdx(1));
title("Topic " + topicIdx(1))
subplot(1,2,2)
wordcloud(mdl,topicIdx(2));
title("Topic " + topicIdx(2))
入力引数
名前と値の引数
出力引数
詳細
"潜在的ディリクレ配分" (LDA) モデルは、文書のコレクションに内在するトピックを発見し、トピック内の単語の確率を推測する文書トピック モデルです。LDA は、D 個の文書のコレクションを、単語確率 のベクトルによって特徴付けられた K 個のトピックにわたって、トピック混合率 としてモデル化します。このモデルは、トピック混合率 とトピック がそれぞれ集中度パラメーター と をもつディリクレ分布に従うと仮定します。
トピックの混合率 は、長さ K の確率ベクトルです。ここで、K はトピックの数です。エントリ は、トピック i が d 番目の文書に出現する確率です。トピックの混合率は、ldaModel オブジェクトの DocumentTopicProbabilities プロパティの行に対応します。
トピック は、長さ V の確率ベクトルです。ここで、V はボキャブラリの単語数です。エントリ は、ボキャブラリの v 番目の単語が i 番目のトピックに出現する確率に対応します。トピック は、ldaModel オブジェクトの TopicWordProbabilities プロパティの列に対応します。
トピック とそのトピック混合率でのディリクレ事前分布 について、LDA は文書に対して次の生成プロセスを仮定します。
トピックの混合率を でサンプリングします。確率変数 は、長さ K の確率ベクトルです。ここで、K はトピックの数です。
文書内の単語ごとに、次のようにします。
トピック インデックスを でサンプリングします。確率変数 z は 1 から K までの整数です。ここで、K はトピックの数です。
単語を でサンプリングします。確率変数 w は 1 ~ V の整数です。ここで、V はボキャブラリの単語数であり、ボキャブラリ内の対応する単語を表します。
この生成プロセスの下で、単語 を含む文書の同時分布と、トピックの混合率 、トピック インデックス が次によって与えられます。
ここで、N は文書内の単語数です。z に対する同時分布を合計し、 で積分することで、文書 w の周辺分布が得られます。
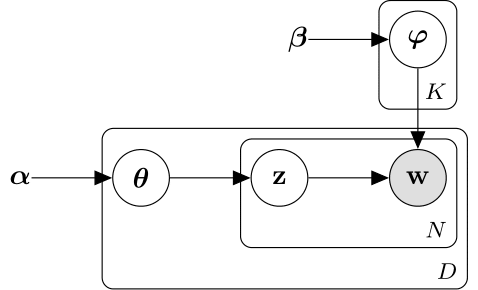
次の図は、LDA モデルを確率的グラフィカル モデルとして示したものです。網かけのあるノードは観測変数、網かけのないノードは潜在変数、枠線のないノードはモデル パラメーターです。矢印は確率変数間の依存関係を強調しており、各グループは繰り返しノードを示しています。
参照
[1] Foulds, James, Levi Boyles, Christopher DuBois, Padhraic Smyth, and Max Welling. "Stochastic collapsed variational Bayesian inference for latent Dirichlet allocation." In Proceedings of the 19th ACM SIGKDD international conference on Knowledge discovery and data mining, pp. 446–454. ACM, 2013.
[2] Hoffman, Matthew D., David M. Blei, Chong Wang, and John Paisley. "Stochastic variational inference." The Journal of Machine Learning Research 14, no. 1 (2013): 1303–1347.
[3] Griffiths, Thomas L., and Mark Steyvers. "Finding scientific topics." Proceedings of the National academy of Sciences 101, no. suppl 1 (2004): 5228–5235.
[4] Asuncion, Arthur, Max Welling, Padhraic Smyth, and Yee Whye Teh. "On smoothing and inference for topic models." In Proceedings of the Twenty-Fifth Conference on Uncertainty in Artificial Intelligence, pp. 27–34. AUAI Press, 2009.
[5] Teh, Yee W., David Newman, and Max Welling. "A collapsed variational Bayesian inference algorithm for latent Dirichlet allocation." In Advances in neural information processing systems, pp. 1353–1360. 2007.

