zscore
R2026b標準化された z スコア
構文
説明
Z = zscore(X)X の各要素について、X のその列が平均値が 0 になるようセンタリングされ、標準偏差が 1 になるようスケーリングされるような z スコアを返します。Z は X と同じサイズになります。
Xがベクトルの場合、Zは z スコアのベクトルになります。Xが行列の場合、ZはXと同じサイズの行列になり、Zの各列の平均が 0、標準偏差が 1 になります。多次元配列の場合、
Zの z スコアはXの大きさが 1 でない最初の次元に対して計算されます。Xの列が同一の値で構成されている場合、Zの対応する値はすべてゼロになります。
例
2 つのデータ ベクトルの スコアを計算してプロットし、結果を比較します。
標本データを読み込みます。
load lawdataワークスペースには 2 つの変数が読み込まれます。gpa と lsat。
両方の変数を同じ軸上にプロットします。
plot([gpa,lsat])
legend('gpa','lsat','Location','East')
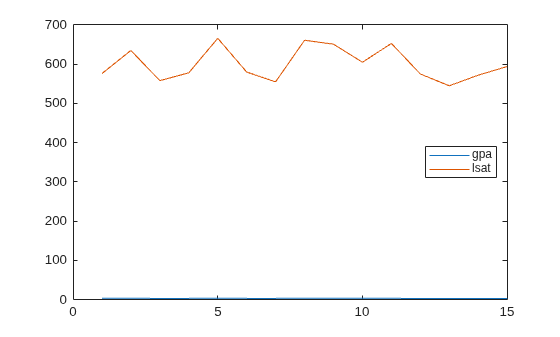
これら 2 つの測定値はスケールが異なるため、比較するのが困難です。
gpa と lsat の スコアを同じ座標軸にプロットします。
Zgpa = zscore(gpa);
Zlsat = zscore(lsat);
plot([Zgpa, Zlsat])
legend('gpa z-scores','lsat z-scores','Location','Northeast')
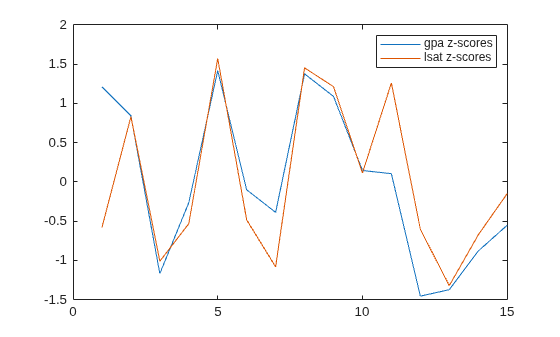
すると、gpa と lsat の両方の結果について各個人の相対的な成績を見ることができます。たとえば、3 人目の gpa と lsat の結果は両方とも標本平均より 1 標準偏差低くなっています。また、11 人目の gpa は標本平均とほぼ同じですが、lsat のスコアは標本平均を 1.25 標準偏差ほど上回っています。
作成した スコアの平均と標準偏差をチェックします。
mean([Zgpa,Zlsat])
ans = 1×2
10-14 ×

   -0.1088    0.0357
std([Zgpa,Zlsat])
ans = 1×2

     1     1
定義により、gpa と lsat の スコアは平均が 0、標準偏差が 1 です。
標本データを読み込みます。
load lawdataワークスペースには 2 つの変数が読み込まれます。gpa と lsat。
標準偏差について母集団の式を使用して、gpa の スコアを計算します。
Z1 = zscore(gpa,1); % population formula
Z0 = zscore(gpa,0); % sample formula
disp([Z1 Z0])
    1.2554    1.2128
    0.8728    0.8432
   -1.2100   -1.1690
   -0.2749   -0.2656
    1.4679    1.4181
   -0.1049   -0.1013
   -0.4024   -0.3888
    1.4254    1.3771
    1.1279    1.0896
    0.1502    0.1451
    0.1077    0.1040
   -1.5076   -1.4565
   -1.4226   -1.3743
   -0.9125   -0.8815
   -0.5724   -0.5530
母集団から派生した標本では、分母が である母標準偏差の式が母標準偏差の最尤推定量に対応し、偏りがある可能性があります。これに対して標本標準偏差式は、標本の母標準偏差の不偏推定量です。
データ行列の列または行に沿って計算した平均および標準偏差を使用して、 スコアを計算します。
標本データを読み込みます。
load fluTable
flu
flu = 52×11 table
Date NE MidAtl ENCentral WNCentral SAtl ESCentral WSCentral Mtn Pac WtdILI
______________ _____ ______ _________ _________ _____ _________ _________ _____ _____ ______
{'10/9/2005' } 0.97 1.025 1.232 1.286 1.082 1.457 1.1 0.981 0.971 1.182
{'10/16/2005'} 1.136 1.06 1.228 1.286 1.146 1.644 1.123 0.976 0.917 1.22
{'10/23/2005'} 1.135 1.172 1.278 1.536 1.274 1.556 1.236 1.102 0.895 1.31
{'10/30/2005'} 1.52 1.489 1.576 1.794 1.59 2.252 1.612 1.321 1.082 1.343
{'11/6/2005' } 1.365 1.394 1.53 1.825 1.62 2.059 1.471 1.453 1.118 1.586
{'11/13/2005'} 1.39 1.477 1.506 1.9 1.683 1.813 1.464 1.388 1.204 1.47
{'11/20/2005'} 1.212 1.231 1.295 1.495 1.347 1.794 1.303 1.371 1.137 1.611
{'11/27/2005'} 1.477 1.546 1.557 1.855 1.678 2.159 1.739 1.628 1.443 1.827
{'12/4/2005' } 1.285 1.43 1.482 1.635 1.577 1.903 1.53 1.701 1.516 1.776
{'12/11/2005'} 1.354 1.45 1.46 1.794 1.583 1.894 1.831 2.364 2.094 1.941
{'12/18/2005'} 1.502 1.622 1.638 1.988 1.947 2.22 2.577 3.89 2.66 2.34
{'12/25/2005'} 1.86 1.915 1.955 2.38 2.343 3.027 3.219 4.862 2.595 3.086
{'1/1/2006' } 2.114 2.174 2.065 2.557 2.275 2.498 2.644 3.352 2.181 3.26
{'1/8/2006' } 1.815 1.932 1.822 2.046 1.969 1.805 2.189 2.132 1.717 2.613
{'1/15/2006' } 1.541 1.695 1.581 2.008 1.718 1.662 2.156 1.694 1.351 2.247
{'1/22/2006' } 1.632 1.758 1.711 2.217 1.866 2.194 2.268 1.826 1.384 2.352
⋮
table flu には 11 個の変数について 52 の観測値があります。最初の変数には日付 (週単位) が含まれています。ほかの変数には、米国の各地域別のインフルエンザ推定発生件数が含まれています。
table をデータ行列に変換します。
flu2 = table2array(flu(:,2:end));
新しいデータ行列 flu2 は 52 行 10 列のデータ行列です。行はデータ セット配列 flu 内の週に対応し、列は米国の各地域に対応します。
地域ごと (flu2 の "列") のインフルエンザ推定発生件数を標準化します。
Z1 = zscore(flu2,[ ],1);
変数エディターで スコアを確認するには、ワークスペースで作成した行列 Z1 をダブルクリックします。
週ごと (flu2 の "行") のインフルエンザ推定発生件数を標準化します。
Z2 = zscore(flu2,[ ],2);
さまざまな次元に沿ってデータを標準化するよう指定して、多次元配列の z スコアを求めます。入力引数 'all'、dim および vecdim を使用した場合の結果を比較します。
3 x 4 x 2 の配列を作成します。
X = reshape(1:24,[3 4 2])
X =
X(:,:,1) =

     1     4     7    10
     2     5     8    11
     3     6     9    12


X(:,:,2) =

    13    16    19    22
    14    17    20    23
    15    18    21    24
X のすべての値の平均および標準偏差を使用して、X を標準化します。
Zall = zscore(X,0,'all')Zall =
Zall(:,:,1) =
-1.6263 -1.2021 -0.7778 -0.3536
-1.4849 -1.0607 -0.6364 -0.2121
-1.3435 -0.9192 -0.4950 -0.0707
Zall(:,:,2) =
0.0707 0.4950 0.9192 1.3435
0.2121 0.6364 1.0607 1.4849
0.3536 0.7778 1.2021 1.6263
生成された z スコアの多次元配列は、平均が 0、標準偏差が 1 です。たとえば、Zall の平均と標準偏差を計算します。
mZall = mean(Zall(:,:,:),'all')mZall = -9.2519e-18
sZall = std(Zall(:,:,:),0,'all')sZall = 1.0000
次に、2 番目の次元に沿って X を標準化します。
Zdim = zscore(X,0,2)
Zdim =
Zdim(:,:,1) =

   -1.1619   -0.3873    0.3873    1.1619
   -1.1619   -0.3873    0.3873    1.1619
   -1.1619   -0.3873    0.3873    1.1619


Zdim(:,:,2) =

   -1.1619   -0.3873    0.3873    1.1619
   -1.1619   -0.3873    0.3873    1.1619
   -1.1619   -0.3873    0.3873    1.1619
Zdim の各ページの各行の要素は、平均が 0、標準偏差が 1 です。たとえば、Zdim の 2 ページ目の 1 行目の平均と標準偏差を計算します。
mZdim = mean(Zdim(1,:,2),'all')mZdim = 0
sZdim = std(Zdim(1,:,2),0,'all')sZdim = 1
最後に、2 番目および 3 番目の次元に基づいて X を標準化します。
Zvecdim = zscore(X,0,[2 3])
Zvecdim =
Zvecdim(:,:,1) =

   -1.4289   -1.0206   -0.6124   -0.2041
   -1.4289   -1.0206   -0.6124   -0.2041
   -1.4289   -1.0206   -0.6124   -0.2041


Zvecdim(:,:,2) =

    0.2041    0.6124    1.0206    1.4289
    0.2041    0.6124    1.0206    1.4289
    0.2041    0.6124    1.0206    1.4289
各 Zvecdim(i,:,:) スライスの要素は、平均が 0、標準偏差が 1 です。たとえば、Zvecdim(1,:,:) の要素の平均と標準偏差を計算します。
mZvecdim = mean(Zvecdim(1,:,:),'all')mZvecdim = 2.7756e-17
sZvecdim = std(Zvecdim(1,:,:),0,'all')sZvecdim = 1
スコアの計算に使用する平均と標準偏差を取得します。
標本データを読み込みます。
load lawdataワークスペースには 2 つの変数が読み込まれます。gpa と lsat。
gpa の スコア、平均および標準偏差を取得します。
[Z,gpamean,gpastdev] = zscore(gpa)
Z = 15×1

    1.2128
    0.8432
   -1.1690
   -0.2656
    1.4181
   -0.1013
   -0.3888
    1.3771
    1.0896
    0.1451
    0.1040
   -1.4565
   -1.3743
   -0.8815
   -0.5530
gpamean =
3.0947
gpastdev =
0.2435
入力引数
出力引数
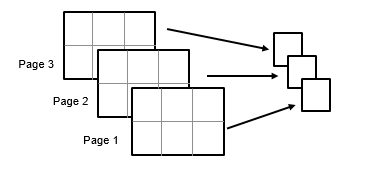
z- スコア。ベクトル、行列、または多次元配列として返されます。Z の次元数は X と同じです。
Z の値は、'all'、dim または vecdim を指定するかどうかによって異なります。これらの入力引数を指定しない場合、以下の条件が適用されます。
Xがベクトルである場合、Zは平均 0 および分散 1 をもつ z スコアのベクトルになります。Xが配列である場合、zscoreはXの大きさが 1 でない最初の次元に沿って標準化を行います。
'all'、dim および vecdim を使用する場合の Z の違いを示す例については、多次元配列の z スコアを参照してください。
詳細
アルゴリズム
zscore は、NaN を含む任意の標本について NaN を返します。
zscore は、一定した (つまりすべての値が同じ) 任意の標本について 0 を返します。たとえば、X が同一の数値から成るベクトルである場合、Z は 0 から成るベクトルになります。
メモ
normalize 関数は、一定した (つまりすべての値が同じ) 任意の標本について NaN の z スコアを返します。
拡張機能
バージョン履歴
R2006a より前に導入
参考
mean | std | normalize | rescale | incrementalNormalizer

