predict
R2026b近傍成分分析 (NCA) 回帰モデルの使用による応答の予測
説明
例
標本データを読み込みます。
load robotarm.matrobotarm データ セットには、ロボット アーム シミュレーターの 7168 個の学習観測値、1024 個のテスト観測値、32 個の特徴量が含まれています[1][2]。この例のデータ セットは、元のデータ セットを前処理したものです。この例で使用するデータ セットは、元のデータ セットを前処理したものです。データの前処理では、線形回帰近似で与えられた値を元のデータから除外した後、すべての特徴量を単位分散に対して正規化しています。
既定値の (正則化パラメーター) を使用して、回帰用の近傍成分分析 (NCA) 特徴選択を実行します。
rng(1,"twister") % For reproducibility
nca = fsrnca(Xtrain,ytrain,FitMethod="exact",Solver="lbfgs");
選択された値をプロットします。
figure
plot(nca.FeatureWeights,"ro")
xlabel("Feature Index")
ylabel("Feature Weight")
grid on
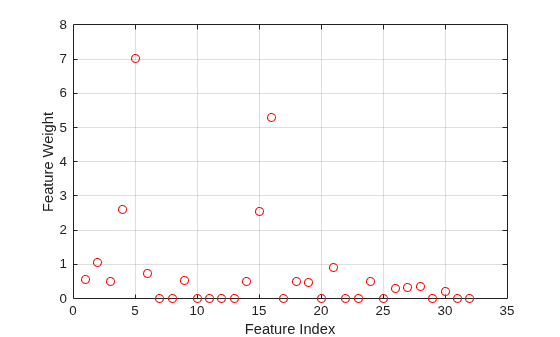
特徴量の重みは半分以上が非ゼロです。テスト セットを性能の尺度として使用し、選択された特徴量を使用して損失を計算します。
L = loss(nca,Xtest,ytest)
L =
0.0837
テスト セットについて予測される応答値を計算し、実際の応答に対してプロットします。
ypred = predict(nca,Xtest);
figure
plot(ypred,ytest,"bo")
axis square
grid on
xlim([-4 4])
ylim([-4 4])
xlabel("Predicted Response")
ylabel("Actual Response")
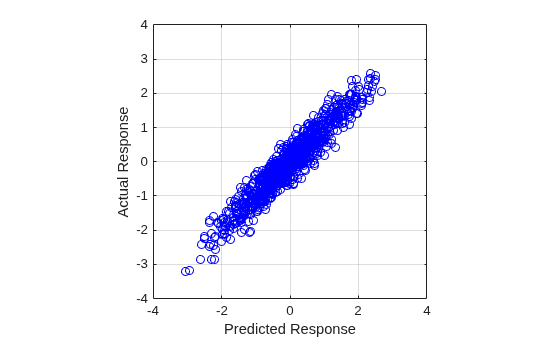
実際の値に完全に一致すると、45°の直線になります。このプロットでは、予測された応答値と実際の応答値がこの直線の周辺に分布しているように見えます。
性能の改善を試みます。5 分割交差検証を使用して、特徴選択の正則化パラメーター を調整します。 の調整とは、回帰損失が最小になる の値を求めることを意味します。
はじめに、データを 5 つの分割に分割します。各分割について、cvpartition は各データの 4/5 を学習セットとして、1/5 をテスト セットとして割り当てます。
n = length(ytrain);
cvp = cvpartition(length(ytrain),KFold=5);
numvalidsets = cvp.NumTestSets;
探索用の の値を割り当てます。応答値に定数を乗算すると、損失関数項はその定数倍になります。したがって、係数 std(ytrain) を の値に含めると、目的関数で既定の損失関数 ("mad"、平均絶対偏差) 項と正則化項のバランスがとれます。この例では、読み込んだ標本データは元のデータ セットを前処理したバージョンなので、係数 std(ytrain) は 1 です。
lambdavals = linspace(0,50,20)*std(ytrain)/n;
損失値を格納する配列を作成します。
lossvals = zeros(length(lambdavals),numvalidsets);
各分割の学習セットを使用して、 の各値について NCA モデルに学習させます。NCA モデルを使用して分割内の対応するテスト セットの回帰損失を計算し、損失の値を記録します。このプロセスを の各値および各分割に対して繰り返します。
for i = 1:length(lambdavals)
    for k = 1:numvalidsets
        X = Xtrain(cvp.training(k),:);
        y = ytrain(cvp.training(k),:);
        Xvalid = Xtrain(cvp.test(k),:);
        yvalid = ytrain(cvp.test(k),:);

        nca = fsrnca(X,y,FitMethod="exact", ...
             Solver="minibatch-lbfgs",Lambda=lambdavals(i), ...
             GradientTolerance=1e-4,IterationLimit=30);

        lossvals(i,k) = loss(nca,Xvalid,yvalid,LossFunction="mse");
    end
end
の各値について、分割から得られる平均損失を計算します。
meanloss = mean(lossvals,2);
平均損失と の値をプロットします。
figure
plot(lambdavals,meanloss,"ro-")
xlabel("Lambda")
ylabel("Loss (MSE)")
grid on
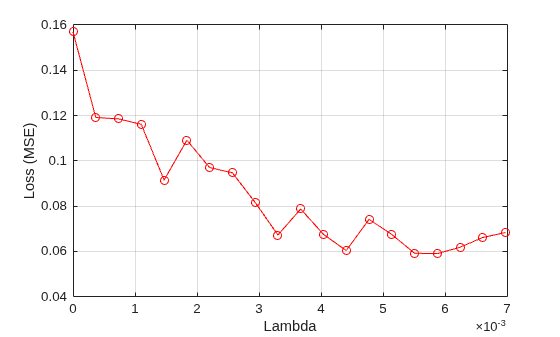
損失の値が最小になる の値を求めます。
[~,idx] = min(meanloss)
idx =
17
bestlambda = lambdavals(idx)
bestlambda =
0.0059
bestloss = meanloss(idx)
bestloss =
0.0590
最適な の値を使用して、回帰用の NCA 特徴選択モデルを当てはめます。
nca2 = fsrnca(Xtrain,ytrain,FitMethod="exact", ...
    Solver="lbfgs",Lambda=bestlambda);
選択された特徴量をプロットします。
figure
plot(nca2.FeatureWeights,"ro")
xlabel("Feature Index")
ylabel("Feature Weight")
grid on
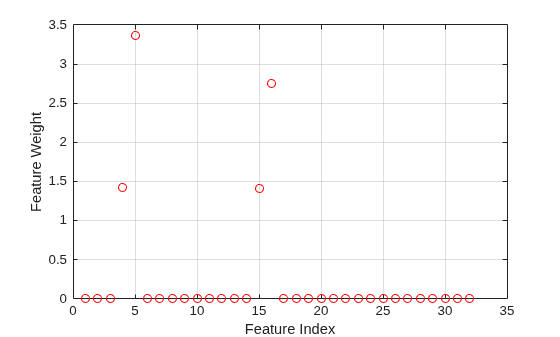
特徴量の重みはほとんどがゼロになります。fsrnca は、最も関連性がある 4 つの特徴量を特定しています。
テスト セットの損失を計算します。
L = loss(nca2,Xtest,ytest)
L =
0.0571
正則化パラメーター の調整により、無関係な特徴量がさらに除外され、性能が向上します。
予測された応答値とテスト セット内の実際の応答値をプロットします。
ypred = predict(nca2,Xtest);
figure
plot(ypred,ytest,"bo")
axis square
grid on
xlim([-4 4])
ylim([-4 4])
xlabel("Predicted Response")
ylabel("Actual Response")
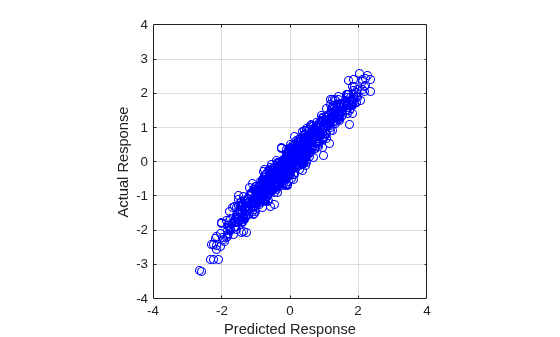
予測された応答値は、実際の値に近いように見えます。
入力引数
出力引数
バージョン履歴
R2016b で導入

