決定木のバギングによる格付け
R2026bこの例では、自動信用格付けツールの作成方法を示します。
信用リスク管理における基本的作業の 1 つは、借り手を格付けすることです。"等級" を使用して、認識された弁済能力に応じて顧客を格付けします。等級が高いほど、信用リスクが低くなります。等級が近ければ、信用リスクのレベルも近いことになります。等級のカテゴリは、"格付け" と "与信スコア" の 2 つです。格付けは少数の異なるクラスで構成され、通常は AAA や BB- などのラベルが付けられます。与信スコアは、640 や 720 などの数値で表された等級です。信用度の等級は、規制の枠組み (Basel II など) における主要な要素の 1 つです (バーゼル銀行監督委員会 [3] を参照してください)。
信用格付けを行うには、借り手に関する情報を分析する必要があります。借り手が個人である場合、対象となる情報はその個人の収入、未払い負債 (住宅ローンやクレジット カードなど)、世帯規模、住宅の状況などです。借り手が企業である場合、財務比率 (売上高を総資産で割った値など) や業種を考慮するかもしれません。ここでは借り手に関するこのような情報を "特徴量" または "予測子" と呼びます。格付け機関が異なれば、使用される予測子も異なります。また、顧客を格付けするための格付けクラスやスコア範囲も異なることがあります。規模の大きい借り手市場に比較的少額のローンを提供する場合 (たとえば、クレジット カード)、与信スコアを使用するのが一般的であり、借り手を格付けするプロセスは通常は自動化されています。ローンが高額で、中小企業や大企業が利用できる場合、格付けを使用するのが一般的であり、自動化されたアルゴリズムと専門家の分析を組み合わせて格付けすることがあります。
格付機関の業務は、企業の信用度の追跡です。多くの銀行は顧客を格付けするための独自の方法論を開発しています。ある顧客を社内で格付けすることが必要になるのは、その顧客がまだ格付機関によって格付けされたことがなく、たとえ第三者による格付けがあったとしても、社内で格付けすることにより顧客のリスク プロフィールの評価が補える場合です。
この例では、格付けプロセスの自動化段階で MATLAB® を活用する方法を説明します。特に、Statistics and Machine Learning Toolbox™ で容易に使用できる統計学習ツールの 1 つである、"バギングされた決定木" として知られる分類アルゴリズムを活用します。
この例では、履歴情報をデータ セットの形で入手でき、各レコードには借り手の特徴量と割り当てられた格付けが含まれているものとします。この格付けは、施行済みの手順とポリシーに従う委員会によって割り当てられた社内格付けであることもあります。または、格付機関による格付けのこともあります。そのような格付けは、社内格付けシステムを新規に始動するために使用されます。
最初に必要となるのは既存の履歴データです。このデータを使用して、格付けの自動化に使用するバギングされた決定木を "学習" させます。統計学習の語彙では、この学習プロセスは "教師あり学習" のカテゴリに属します。したがって、新規顧客の格付けには分類器が使用されます。実際問題としては、この自動化された格付け、つまり "予測された" 格付けは暫定的なものと見なされる可能性が高く、専門家で構成される信用調査委員会が審査して始めて確定します。また、この例で使用する種類の分類器では、予測された格付けの確実性の尺度である "分類スコア" が表示されるため、格付けの見直しも簡単にできるようになります。
実際には、最初に行う必要があるのは分類器の学習であり、次にその分類器を使用して新規顧客を格付けし、最後に分類器の質つまり精度の "プロファイリング" または "評価" を行う必要もあります。このプロセスは "検証" または "バックテスト" とも呼ばれます。この例では、簡単に入手できるバックテスト ツールについても説明します。
既存の格付けデータの読み込み
コンマ区切りテキスト ファイル CreditRating_Historical.dat から履歴データを読み込みます。この例ではテキスト ファイルを操作しますが、Database Toolbox™ にアクセスできる場合、この情報をデータベースから直接読み込めます。
データ セットには、企業顧客リストに名を連ねる顧客の財務比率、業種、および格付けが含まれます。このデータは、実際のデータではなくシミュレーションされたものです。1 列目は顧客 ID です。続く 5 列は財務比率です。これらの比率は Altman's z-score で使用される比率と同じです (Altman [1] を参照。関連する分析については Loeffler および Posch [4] も参照)。
運転資本/総資産 (
WC_TA)内部留保/総資産 (
RE_TA)税引前利払前利益/総資産 (
EBIT_TA)株式時価総額/全債務の簿価 (
MVE_BVTD)売上高/総資産 (
S_TA)
次は、1 ~ 12 の範囲にある整数値で表されている業種ラベルです。最後の列には、顧客に割り当てられた格付けが格納されています。
データを table 配列に読み込みます。
creditDS = readtable("CreditRating_Historical.dat");特徴量を行列 X に、対応するクラスである格付けをベクトル Y にコピーします。この情報には table から直接アクセスできるので、この手順は必須ではありません。この例で手順を実行するのは、これ以降で繰り返されるいくつかの関数呼び出しを単純化するためです。
行列 X に格納される特徴量は、財務比率 5 つと業種ラベルです。Industry は実際にはカテゴリカル変数の一種である "ノミナル" 変数です。業種には順序は存在しないからです。これに対する応答変数、つまり格付けも、カテゴリカル変数です。ただし、こちらは "序数" 変数です。定義では、格付けは信用度の "ランキング" を示唆するからです。例では、この変数を"そのまま"使用して、分類器に学習させます。ここでは、この変数を "順序配列" にコピーします。こうすることにより、格付けの順序どおりに出力されて読みやすくなるからです。格付けの順序は、Y の定義の 3 番目の引数として渡す cell 配列によって確立されます。格付けは、数値にマッピングもできます。数値へのマッピングは、別のデータ解析方法 (回帰など) を試すときに便利です。実際問題として、さまざまな方法を試すことをお勧めします。
X = [creditDS.WC_TA creditDS.RE_TA creditDS.EBIT_TA creditDS.MVE_BVTD ...
     creditDS.S_TA creditDS.Industry];
Y = ordinal(creditDS.Rating);
予測子 X と応答変数 Y を使用して、"バギングされた決定木" と呼ばれる特定の種類のアンサンブル分類を当てはめます。"バギング" は bootstrap aggregation を意味します。この方法論の本質は、データ セットからのサブサンプリング、つまり "ブートストラップ レプリカ" をいくつか生成することにあります。これらのサブサンプリングは無作為に生成されます。これは、データ セット内の顧客リストに基づく復元抽出法です。レプリカごとに決定木が 1 つ成長します。各決定木は、独自に学習させた分類器であり、新規顧客の分類に単独で使用することができます。ただし、2 つのブートストラップ レプリカから成長した 2 本の木の予測は異なる可能性があります。このアンサンブルは、ブートストラップ レプリカすべてに対して成長した決定木すべての予測を "集約" します。木の大多数が、ある新規顧客について 1 つのクラスを予測した場合、その予測は単独の木による予測より確実であると考えるのは、道理にかなっています。さらに、少数の木が別のクラスを予測した場合、その情報も有益です。実際、別のクラスを予測する木の比率は、新規データの分類時にアンサンブル分類により報告される "分類スコア" の土台となります。
ツリー バッガーの作成
アンサンブル分類を作成する最初の手順は、個別の木に適したリーフ サイズを見つけることです。この例では、1、5 および 10 というサイズを試します (TreeBagger の詳細は、Statistics and Machine Learning Toolbox のドキュメンテーションを参照してください)。最初は少数の 25 本の木から始めます。主要な目的が、さまざまなリーフ サイズでの分類誤差の初期トレンドを比較することだからです。再現可能性と公平な比較を確保するため、乱数発生器を再初期化します。これは、分類器を作成するたびに、データからの復元抽出法による標本抽出に使用されます。
leaf = [1 5 10];
nTrees = 25;
rng(9876,"twister");
savedRng = rng; % Save the current RNG settings

color = lines(3);
for ii = 1:length(leaf)
   % Reinitialize the random number generator, so that the
   % random samples are the same for each leaf size
   rng(savedRng)
   % Create a bagged decision tree for each leaf size and plot out-of-bag
   % error "oobError"
   b = TreeBagger(nTrees,X,Y,OOBPrediction="on", ...
                             CategoricalPredictors=6, ...
                             MinLeafSize=leaf(ii));
plot(oobError(b),Color=color(ii,:))
   hold on
end
xlabel("Number of grown trees")
ylabel("Out-of-bag classification error")
legend(["1","5","10"],Location="northeast")
title("Classification Error for Different Leaf Sizes")
hold off
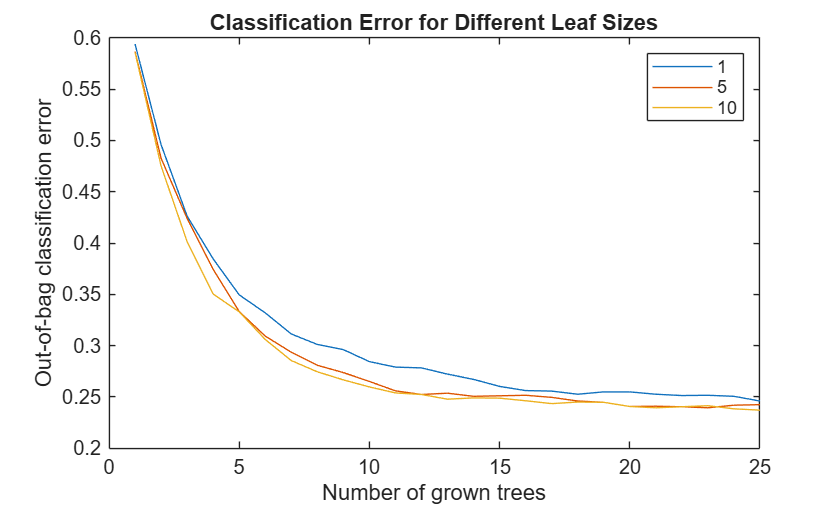
これら 3 種類のリーフ サイズについて、誤差を比較することができます。したがって、リーフ サイズ 10 について検討することにします。この方が無駄がなく、計算の効率性が高いからです。
データを "学習用" と "テスト用" のサブセットに分割する必要はなかったことに注意してください。これは、この手法の元となるサンプリング法において暗黙的であり、内部的に行われます。ブートストラップを反復するたびに、ブートストラップ レプリカが学習セットになります。除外された ("out-of-bag") 顧客がいれば、その顧客は前に報告された out-of-bag 分類誤差を評価するためのテスト ポイントとして使用されます。
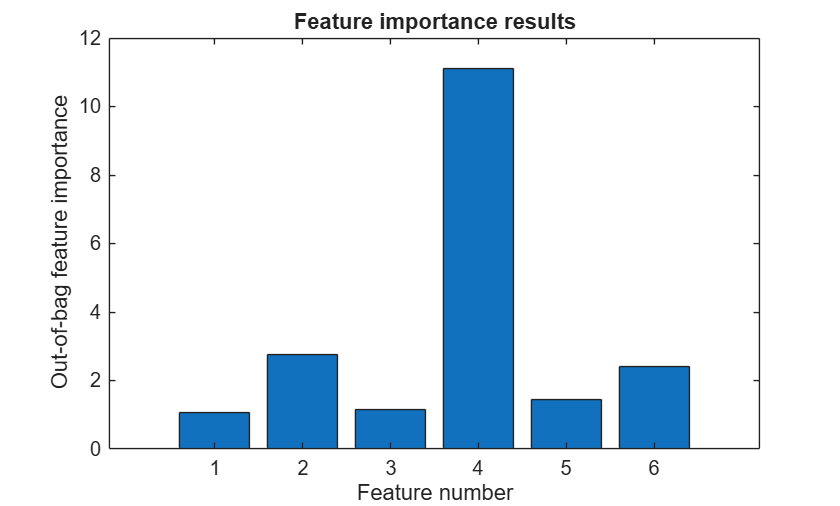
次に、分類器の精度にとってあらゆる特徴量が重要なのかどうかを調べます。そのために、"特徴量の重要度" 測定項目 (OOBPredictorImportance) を有効にし、最も重要な特徴を視覚的に見つけるために結果をプロットします。次に、木の本数を増やしてみて、分類誤差を保存します。後でさらに比較するためです。
nTrees = 50;
leaf = 10;
rng(savedRng);
b = TreeBagger(nTrees,X,Y,OOBPredictorImportance="on", ...
                          CategoricalPredictors=6, ...
                          MinLeafSize=leaf);

bar(b.OOBPermutedPredictorDeltaError)
xlabel("Feature number")
ylabel("Out-of-bag feature importance")
title("Feature importance results")
oobErrorFullX = oobError(b);
特徴量 2、4 および 6 は、その他の特徴量とは一線を画しています。特徴量 4 は、株式時価総額/全債務の簿価 (MVE_BVTD) ですが、このデータ セットにとって最も重要な予測子です。この比率は、Merton のモデル [5] など、構造モデルにおける信用度の予測子に密接に関係しています。ここで、債務不履行確率を判断するため、企業の株式の値を未払い負債と比較します。
業種情報の特徴 6 (Industry) も、このデータ セットに関して企業の信用度を評価する点で、その他の変数より相対的に重要です。
MVE_BVTD ほどには重要ではありませんが、特徴 2 (内部留保/総資産 (RE_TA)) もその他の特徴量とは一線を画しています。内部留保と企業の存続年数には、相関関係があります (一般に、存続年数が長ければ長いほど、蓄積できる内部留保は増えます)。そして、企業の存続年数は信用度と相関関係があります (歴史の長い企業ほど、困難な時期を乗り越えられる可能性は高くなります)。
予測子 RE_TA、MVE_BVTD、および Industry のみを使用して、新しいアンサンブル分類を当てはめます。分類誤差と以前の分類器を比較します。この以前の分類器では特徴がすべて使用されます。
X = [creditDS.RE_TA creditDS.MVE_BVTD creditDS.Industry];

rng(savedRng)
b = TreeBagger(nTrees,X,Y,OOBPrediction="on", ...
                          CategoricalPredictors=3, ...
                          MinLeafSize=leaf);

oobErrorX246 = oobError(b);

plot(oobErrorFullX)
hold on
plot(oobErrorX246)
xlabel("Number of grown trees")
ylabel("Out-of-bag classification error")
legend(["All features","Features 2, 4, 6"],Location="northeast")
title("Classification Error for Different Sets of Predictors")
hold off
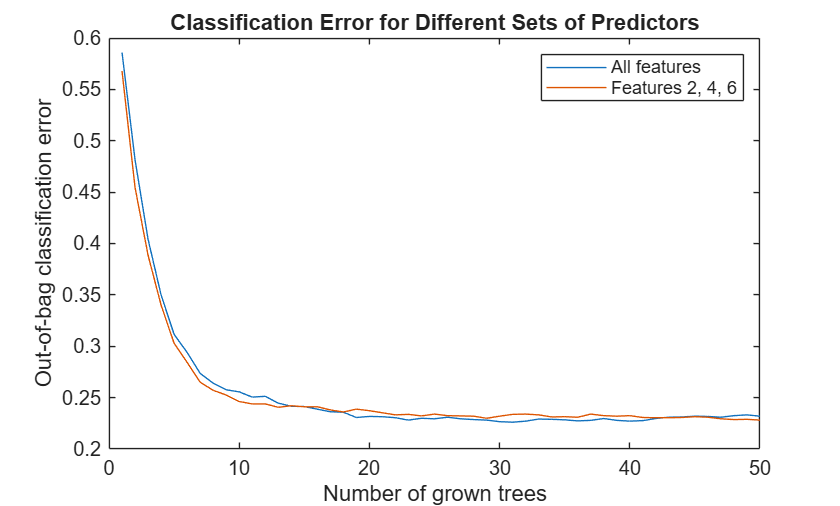
重要度が相対的に低い特徴量 (1、3、および 5) を除外しても分類精度は大きく低下しないので、予測には特徴量を削減したアンサンブル分類を使用します。
この例では、6 個のみの特徴量で構成されるセットで開始し、変数のうち 3 つをスクリーニングで除外するための基準として分類器の特徴量重要度測定法と out-of-bag 分類誤差を使用しました。予測子の初期セットに変数が多数含まれる場合、特徴の選択に時間がかかってしまう可能性があります。ここで使用したツール (変数重要度と out-of-bag 誤差の "視覚的" 比較) 以外に、Statistics and Machine Learning Toolbox で使用できる他の変数選択ツールもこの種の分析に役立つことがあります。ただし、結局のところ、特徴選択を成功させるには計量的分析手法に分析者の判断を加味することが必要になります。
たとえば、ここで使用した変数重要度測定法は、ある特徴の相対的な影響度を見積もるランク付けのしくみです。見積もるには、この特徴の値がランダムに置換された場合に分類器の予測精度がどの程度低下するのかを測定します。基本となる考え方は、問題の特徴が分類器の予測力にあまり貢献しないのであれば、値を変更 (この場合は置換) して使用しても分類の結果は影響を受けないはずだ、というものです。一方、予測精度を低下させることなく関連情報をランダムに入れ替えることはできません。以上のことから、2 つの相関する特徴量が重要である場合、いずれもこの分析で上位にランクインします。その場合、正確な分類にはこれらの特徴量の 1 つを維持すれば十分ですが、そのことはランク付けの結果だけからはわかりません。相関性を個別にチェックするか、専門家の判断を加味する必要があります。つまり、変数重要度や sequentialfs などの手段は特徴選択に大いに貢献する可能性はあるものの、このプロセスで最も重要なのは分析者の判断だ、ということです。
この時点で、新規顧客を分類するために今後のセッション (load classifier) で読み込むためにこの分類器を保存 (save classifier.mat b など) できます。効率性のため、学習プロセスが終了したらコンパクト版の分類器を保存しておくことをお勧めします。
b = compact(b);
新規データの分類
以前に作成したアンサンブル分類を使用して新規顧客の信用を格付けします。既存顧客の格付けも定期的に見直す必要がある (特に、財務情報が実質的に更新されたとき) ので、データ セットに見直し中の既存顧客のリストも含まれることがあります。新規データの読み込みから始めます。
newDS = readtable("CreditRating_NewCompanies.dat");この新規データの格付けを予測するため、分類器に predict メソッドを呼び出します。このメソッドは、予測クラスと分類スコアという 2 つの引数を返します。このどちらの出力引数も必要なものです。分類スコアには予測された格付けの確実性に関する情報が含まれるからです。以前と同じように、変数 RE_TA、MVE_BVTD、および Industry を行列 X にコピーしてもよいのですが、呼び出すのは predict だけなので、この手順を省略して newDS を直接使用できます。
[predClass,classifScore] = predict(b,[newDS.RE_TA newDS.MVE_BVTD newDS.Industry]);
この時点で、レポートを作成できます。この例では、説明のために最初の 3 件の顧客に関する小さいレポートのみを画面に表示しますが、MATLAB の展開ツールを使用すると、このワークフローを大幅に改善できます。たとえば、クレジット アナリストはこの分類をリモートで実行し、Web ブラウザーでレポートを確認することができます。MATLAB がデスクトップにインストールされている必要はありません。
for i = 1:3
fprintf("Customer %d:\n",newDS.ID(i));
fprintf("   RE/TA    = %5.2f\n",newDS.RE_TA(i));
fprintf("   MVE/BVTD = %5.2f\n",newDS.MVE_BVTD(i));
fprintf("   Industry = %2d\n",newDS.Industry(i));
fprintf("   Predicted Rating : %s\n",predClass{i});
fprintf("   Classification score : \n");
   for j = 1:length(b.ClassNames)
      if (classifScore(i,j)>0)
fprintf("      %s : %5.4f \n",b.ClassNames{j},classifScore(i,j));
      end
   end
end
Customer 60644:
RE/TA = 0.22
MVE/BVTD = 2.40
Industry = 6
Predicted Rating : AA
Classification score :
      A : 0.2332
      AA : 0.7536
      AAA : 0.0011
      BBB : 0.0121
Customer 33083:
RE/TA = 0.24
MVE/BVTD = 1.51
Industry = 4
Predicted Rating : BBB
Classification score :
      A : 0.1060
      BBB : 0.8940
Customer 63830:
RE/TA = 0.18
MVE/BVTD = 1.69
Industry = 7
Predicted Rating : A
Classification score :
      A : 0.6296
      AA : 0.0172
      AAA : 0.0010
      BBB : 0.3522
予測された格付けおよび対応するスコアのレコードを保持することは、分類器の質を定期的に評価する際に役立ちます。この情報を table 配列である predDS に保存できます。
classnames = b.ClassNames;
predDS = [table(newDS.ID,predClass),array2table(classifScore)];
predDS.Properties.VariableNames = ["ID","PredRating",classnames'];
この情報は、たとえば次のコマンドを使用して、コンマ区切りテキスト ファイル PredictedRatings.dat に保存することもできます。
writetable(predDS,"PredictedRatings.dat");
または、Database Toolbox を使用してデータベースに直接書き込むこともできます。
バックテスト: 分類プロセスのプロファイリング
格付けの質をプロファイリングつまり評価するプロセスを "検証" または "バックテスト" といいます。この作業には、関係する測定法と検定が数多くあります (たとえば、バーゼル銀行監督委員会 [2] を参照してください)。この例では、次の 2 つの問題に焦点を当てます。
予測された格付けは実際の格付けと比較してどの程度正確なのでしょうか。ここでいう "予測された格付け" とは、自動化された分類プロセスで得られる格付けを指します。"実際の格付け" とは、信用調査委員会が割り当てる格付けを指します。信用調査委員会は、予測された格付けとその分類スコア、およびその他の情報 (ニュースや経済状況など) を総合的に判断して最終的なランキングを決定します。
実際の格付けは顧客を信用度に従ってどの程度正確にランク付けすることができるのでしょうか。これが行われるのは、ex-post (事後) 分析 (1 年後など) においてです。これくらい時間が経過すれば、その期間中に債務不履行に陥った企業が明らかになるからです。
ファイル CreditRating_ExPost.dat には、前の節で検討した同じ企業に関する "追跡" データが含まれます。このファイルには、委員会がそれらの企業に割り当てた実際の格付けおよび "債務不履行フラグ" が含まれます。債務不履行フラグとは、格付けから 1 年以内にその企業が債務不履行に陥った (1 の場合) かそうでない (0 の場合) かを示す指標です。
exPostDS = readtable("CreditRating_ExPost.dat");予測された格付けと実際の格付けの比較
自動化された分類器に学習させる根拠は、信用調査委員会の作業を促進するためです。予測された格付けが正確であればあるほど、委員会が予測された格付けの見直しに費やさねばならない時間は短縮されます。したがって、予測された格付けが実際に割り当てられた最終格付けにどれほど近いのかを定期的にチェックすること、および食い違いが大きければ、自動化された分類器に再度学習させるよう勧めること (さらに、たとえば新機能の搭載) を委員会が希望するのは考えられることです。
予測された格付けと実際の格付けを比較するために使用できる最初のツールは "混同行列" です。これは、Statistics and Machine Learning Toolbox で容易に使用できます。
C = confusionchart(exPostDS.Rating,predDS.PredRating);
sortClasses(C,["AAA","AA","A","BBB","BB","B","CCC"])
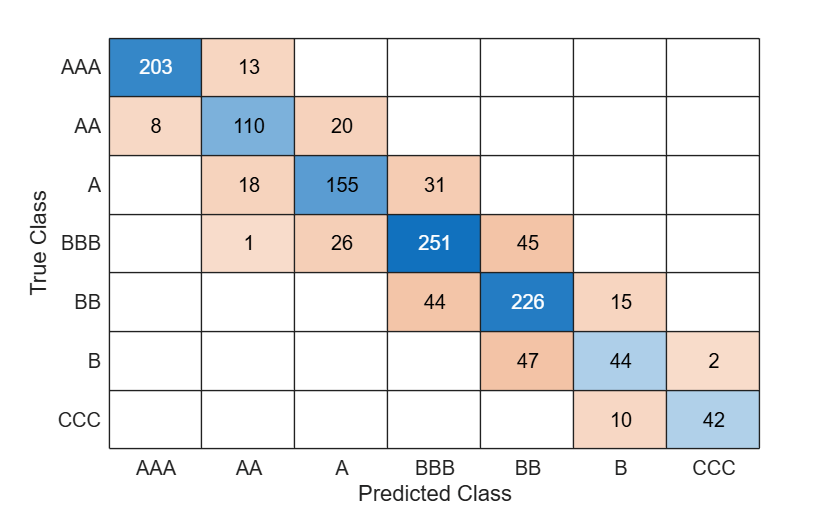
行は実際の格付けに、列は予測された格付けに対応します。混同行列内の位置 (i,j) における値は、実際の格付けが i、予測された格付けが j である顧客の人数を示します。たとえば、位置 (3,2) は信用調査委員会が A と格付けした顧客の数および自動化された分類器で AA と予測された顧客の数を示します。この行列は、パーセントでも表現できます。真の格付けが同じである観測値の個数によって各値を正規化します。
C.Normalization = "row-normalized";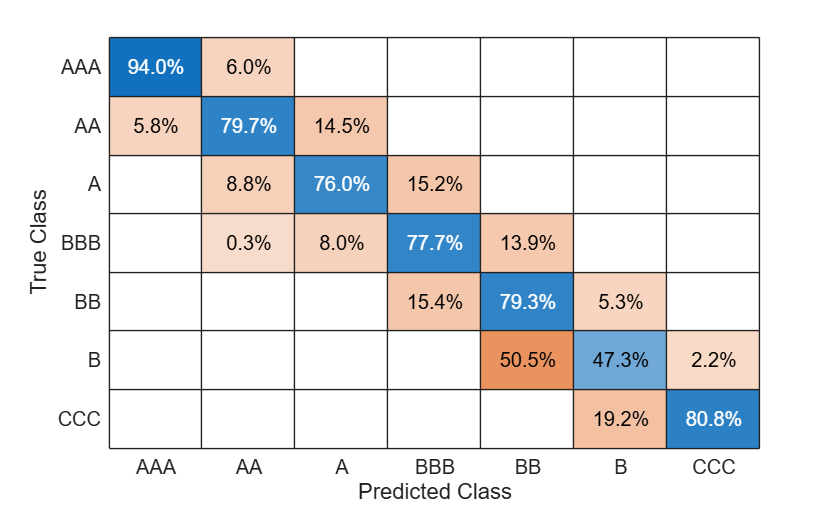
予測された格付けと実際の格付けが十分一致していれば、同じ行においてその他の値に影響を与える主対角要素の値は、理想的には 1 に近くなります。この場合、B には重要な不一致が実際に見られます。信用調査委員会が B と格付けした顧客の約半数は、自動化された分類器では BB と予測されたためです。一方、唯一の例外の BBB を除き、大半のケースで格付けの食い違いがせいぜい 1 段階でしかないのは良いことです。
混同行列を使用して、格付け機関による社内格付けと第三者の格付けを比較することもできます。これは実際によく行われます。
それぞれの特定の格付けについて、予測された格付けと実際の格付けの一致度を別の尺度で計算できます。rocmetricsオブジェクトを使用して、受信者動作特性 (ROC) 曲線を作成し、曲線の下の領域 (AUC) をチェックできます。rocmetrics は、実際の格付け (比較対象とする基準) と自動化されたプロセスによって算出された BBB 分類スコアを取ります。
rocObj1 = rocmetrics(exPostDS.Rating,predDS.BBB,"BBB");rocmetrics の plot 関数を使用して、格付け BBB の ROC 曲線をプロットします。
plot(rocObj1)
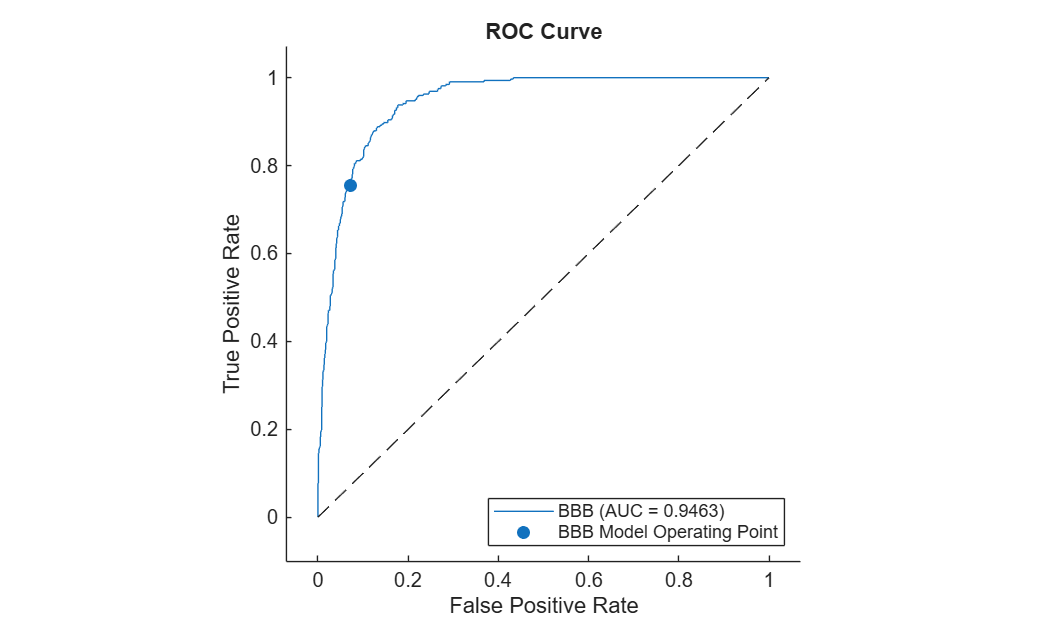
ROC の作成方法を説明します。自動化された分類器が顧客ごとに各格付け、特に BBB の分類スコアを返すことを思い出してください。このスコアは、この特定の顧客が BBB とランク付けされる可能性の高さを表すと解釈することができます。ROC 曲線を作成するには、"分類しきい値" に変化をもたせる必要があります。分類しきい値とは、ある顧客を BBB と分類するための最小スコアのことです。つまり、しきい値が t の場合、BBB スコアが t 以上の場合のみ、その顧客を BBB に分類します。たとえば、XYZ 社の BBB スコアが 0.87 だとします。XYZ 社の実際の格付け (exPostDS.Rating で示された情報) が BBB である場合、XYZ 社は最高 0.87 までの任意のしきい値について正しく BBB と分類されることになります。これは "真陽性" であり、分類器のいわゆる "感度" が向上します。しきい値が 0.87 を超える場合、同社は BBB に格付けされず、偽陰性となります。説明を補足するため、XYZ 社の実際の格付けが BB であるとしましょう。すると、0.87 を超えるしきい値に対しては BBB として正しく却下され、真陰性となり、こうして分類器のいわゆる特異性が向上します。しかし、0.87 までのしきい値に対しては偽陽性になります (実際には BB でも、BBB に分類されます)。ROC 曲線を作成するには、しきい値が 0 ~ 1 の間を動くものとして、真陽性 (感度) と偽陽性 (1 - 特異度) の比率の値をプロットしていきます。
AUC はその名前が示すとおり、ROC 曲線の下の領域です。AUC が 1 に近ければ近いほど、分類器の精度は高くなります (分類器が完全であれば、AUC は 1)。この例では、AUC は十分に高いようですが、どのレベルの AUC だと自動化された分類器を改良するよう勧告するのかを決定するのは信用調査委員会です。
実際の格付けと翌年の債務不履行件数の比較
格付けにおいて暗黙的な顧客のランキングを評価するために使用される一般的な指標は、"累積精度輪郭 (CAP)" およびそれに関連する "精度率" です。基本的な考え方は、割り当てられた格付けと翌年に観測された債務不履行件数との関係を測定する、というものです。格付けのクラスが良いほど、債務不履行の件数は減少するものと思われます。どの格付けでも貸倒発生率が同じであれば、その格付けシステムは単純で役立たずの分類システムであり、顧客は信用度とは無関係にランダムに格付けされていることになります。
rocmetrics を CAP の作成にも使用できることはすぐにわかるはずです。比較対象とする基準は、以前とは異なり格付けではなく、CreditRating_ExPost.dat ファイルから読み込んだ債務不履行フラグです。使用するスコアは "ダミー スコア" で、これは格付けリストで暗黙的な信用度のランキングを示します。ダミー スコアが満たすべき条件は、格が上がるほどダミー スコアは下がる ("債務不履行フラグが 1 になる可能性は低い" という意味)、および 2 つの顧客の格が同じであればダミー スコアも同点になる、ということだけです。債務不履行確率は、もちろんスコアとして渡せますが、ここでは債務不履行確率は不明です。実際のところ、"債務不履行確率の推定値がなくても、CAP を作成できます"。債務不履行確率を検証しているわけではないからです。この例でツールを使用して評価しているのは、顧客をその信用度に従って "ランク付け" するときの格付けの精度です。
通常は、検討対象の格付けシステムの CAP を "完全な格付けシステム" の CAP と共にプロットします。後者は仮説上の格付けシステムであり、格が最低のクラスにはすべての不履行者が分類され、その他の顧客は最低クラスには入れられません。この完全な曲線の下の領域は、格付けシステムが達成し得る AUC の最大値になります。慣例により、"単純なシステム" の CAP の下の面積を減算するためのさまざまな CAP について、AUC が調整されます。"単純なシステム" の CAP とは、顧客をランダムに格付けするシステムの CAP のことです。単純なシステムの CAP は、原点から座標 (1,1) への直線であり、AUC は 0.5 です。したがって、格付けシステムの "精度率" の定義は、調整済み ACU (検討対象システムの AUC から単純なシステムの AUC を引いたもの) と最高精度 (完全なシステムの ACU から単純なシステムの AUC を引いたもの) の比率です。
ratingsList = ["AAA","AA","A","BBB","BB","B","CCC"];
Nratings = length(ratingsList);
dummyDelta = 1/(Nratings+1);
dummyRank = linspace(dummyDelta,1-dummyDelta,Nratings)';

D = exPostDS.Def_tplus1;
fracTotDef = sum(D)/length(D);
maxAcc = 0.5 - 0.5 * fracTotDef;

R = double(ordinal(exPostDS.Rating,[],ratingsList));
S = dummyRank(R);
rocObj2 = rocmetrics(D,S,1,AdditionalMetrics="rpp");
xVal = rocObj2.Metrics.RateOfPositivePredictions;
yVal = rocObj2.Metrics.TruePositiveRate;
auc = rocObj2.AUC;

accRatio = (auc-0.5)/maxAcc;
fprintf("Accuracy ratio for actual ratings: %5.3f\n",accRatio);
Accuracy ratio for actual ratings: 0.850
xPerfect(1) = 0; xPerfect(2) = fracTotDef; xPerfect(3) = 1;
yPerfect(1) = 0; yPerfect(2) = 1; yPerfect(3) = 1;
xNaive(1) = 0; xNaive(2) = 1;
yNaive(1) = 0; yNaive(2) = 1;

plot(xVal,yVal,"-",xPerfect,yPerfect,"--k",xNaive,yNaive,"-.k")
xlabel("Fraction of all companies")
ylabel("Fraction of defaulted companies")
title("Cumulative Accuracy Profile")
legend(["Actual","Perfect","Naive"],Location="southeast")
text(xVal(2)+0.01,yVal(2)-0.01,"CCC")
text(xVal(3)+0.01,yVal(3)-0.02,"B")
text(xVal(4)+0.01,yVal(4)-0.03,"BB")
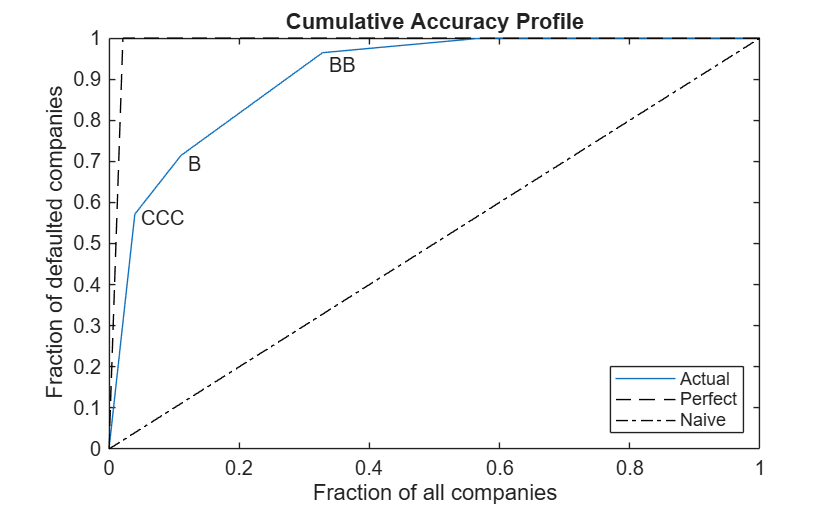
CAP の情報を読み取るポイントは、"ねじれ" にあります。このねじれというレッテルは、格付け CCC、B、および BB のプロットで貼られます。たとえば、2 番目のねじれは 2 番目に低い格付け B に関連付けられており、(0.111, 0.714) にあります。これは、顧客の11.1% が B、つまり比較的低いとランク付けされ、観測された債務不履行件数の 71.4% を占めることを意味します。
一般に、精度率は絶対的な測定値ではなく相対値として処理すべきです。たとえば、予測された格付けの CAP を同じプロットに追加し、精度率を計算して、実際の格付けの精度率と比較できます。
Rpred = double(ordinal(predDS.PredRating,[],ratingsList));
Spred = dummyRank(Rpred);
rocObj3 = rocmetrics(D,Spred,1,AdditionalMetrics="rpp");
xValPred = rocObj3.Metrics.RateOfPositivePredictions;
yValPred = rocObj3.Metrics.TruePositiveRate;
aucPred = rocObj3.AUC;

accRatioPred = (aucPred-0.5)/maxAcc;
fprintf("Accuracy ratio for predicted ratings: %5.3f\n",accRatioPred);
Accuracy ratio for predicted ratings: 0.811
plot(xVal,yVal,"-",xValPred,yValPred,":",xPerfect,yPerfect,"--k", ...
xNaive,yNaive,"-.k")
xlabel("Fraction of all companies")
ylabel("Fraction of defaulted companies")
title("Cumulative Accuracy Profile")
legend(["Actual","Predicted","Perfect","Naive"],Location="southeast")
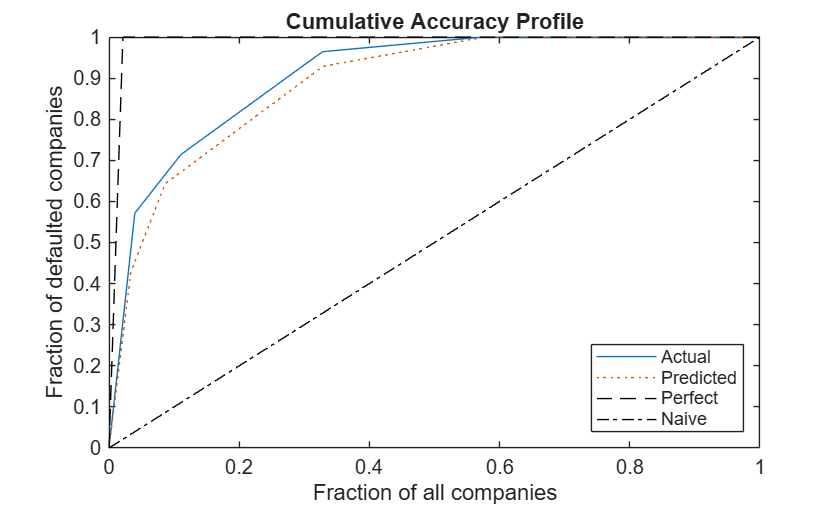
予測された格付けの精度率は下がり、大半のケースでその CAP は実際の格付けの CAP を下回ります。これは当然のことです。実際の格付けは信用調査委員会が、予測された格付けだけでなく格付けの微調整にとって重要な追加情報も考慮して判断したものだからです。
おわりに
MATLAB はバギングされた決定木以外にも多様な機械学習ツールを提供しており、それらも格付けに使用することができます。Statistics and Machine Learning Toolbox には、判別分析や単純ベイズ分類器などの分類ツールが用意されています。MATLAB には、Deep Learning Toolbox™ もあります。さらに、Database Toolbox や MATLAB の展開ツールを使用すると、ここで説明したワークフローをより柔軟に独自の基本設定とニーズに合わせることができる可能性があります。
ここでは、債務不履行確率は計算されていません。格付けでは、格付け移動履歴に基づいて債務不履行確率を計算するのが一般的です。詳細については、Financial Toolbox™ の transprob (Financial Toolbox) リファレンス ページを参照してください。
参考文献
[1] Altman, E."Financial Ratios, Discriminant Analysis and the Prediction of Corporate Bankruptcy."Journal of Finance.Vol. 23, No. 4, (September 1968), pp. 589-609.
[2] Basel Committee on Banking Supervision."Studies on the Validation of Internal Rating Systems."Bank for International Settlements (BIS), Working Papers No. 14, revised version, May 2005.https://www.bis.org/publ/bcbs_wp14.htm で入手可能
[3] Basel Committee on Banking Supervision."International Convergence of Capital Measurement and Capital Standards:A Revised Framework."Bank for International Settlements (BIS), comprehensive version, June 2006.https://www.bis.org/publ/bcbsca.htm で入手可能
[4] Loeffler, G., and P. N. Posch.Credit Risk Modeling Using Excel and VBA.West Sussex, England:Wiley Finance, 2007.
[5] Merton, R."On the Pricing of Corporate Debt:The Risk Structure of Interest Rates."Journal of Finance.Vol. 29, No. 2, (May, 1974), pp. 449-70.

