ドイツ語のテキスト データの解析
R2026bこの例では、トピック モデルを使用して、ドイツ語のテキスト データをインポート、準備、および解析する方法を示します。
ドイツ語のテキスト データは大きくなる可能性があり、統計解析に悪影響を与えるノイズが多く含まれる可能性があります。たとえば、テキスト データに次のような内容が含まれることがあります。
語形のバリエーション。たとえば、„rot*“、„rote“、„roten“*。
ノイズを付加する単語。たとえば、„der*“、„die“、„das“* などのストップ ワード。
句読点と特殊文字。
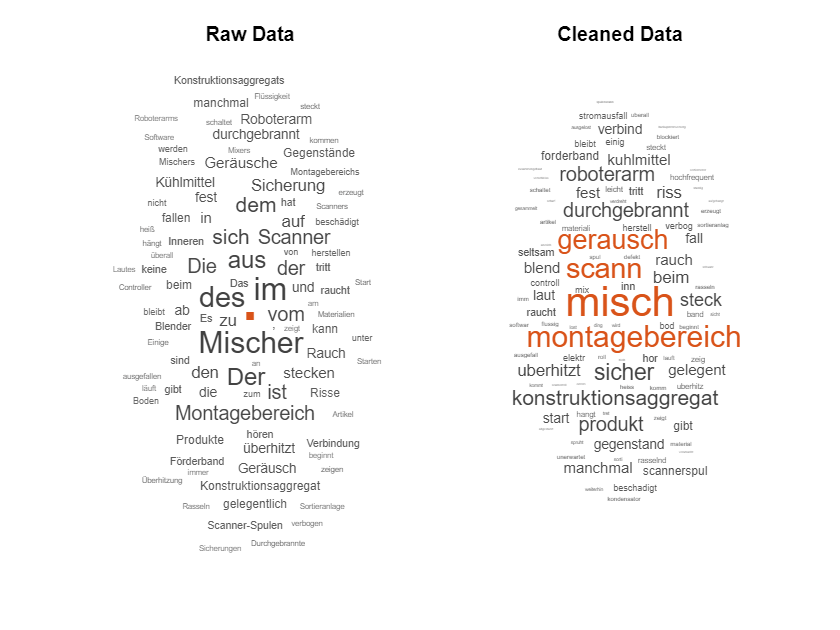
次のワード クラウドは、生テキスト データに適用された単語頻度解析と、同じテキスト データの前処理済みバージョンに適用された単語頻度解析を示しています。
この例では、最初にドイツ語のテキスト データをインポートして準備する方法を示し、次に、潜在的ディリクレ配分 (LDA) モデルを使用してテキスト データを解析する方法を示します。LDA モデルは、文書のコレクションに内在するトピックを発見し、トピック内の単語の確率を推測するトピック モデルです。以下のステップを使用して、テキスト データの準備とモデルの当てはめを行います。
CSV ファイルからテキスト データをインポートし、関連データを抽出する。
標準的な前処理手法を使用して、解析用のテキスト データを準備する。
トピック モデルを当てはめ、結果を可視化する。
データのインポート
サンプル データ "FabrikBerichte.csv" を読み込みます。データには、各イベントのドイツ語での説明テキストとカテゴリカル ラベルを含む工場レポートが格納されています。
readtable 関数を使用してデータを読み込みます。テキスト タイプを string に設定します。列ヘッダーの 1 つにウムラウト ("Auflösung") が含まれています。この名前を維持するには、VariableNamingRule を "preserve" に設定します。そうしなかった場合、MATLAB によって警告が表示され、列ヘッダーからウムラウトが削除されます。
filename = "FabrikBerichte.csv";
data = readtable(filename,TextType="string",VariableNamingRule="preserve");
head(data)
                                       Beschreibung                                             Kategorie          Dringlichkeit        Auflösung        Kosten
    __________________________________________________________________________________    _____________________    _____________    __________________________________    ______

    "Im Inneren des Mixers ist ein lautes Rasseln zu hören."                              "Mechanischer Fehler"      "Niedrig"      "Zur Beobachtungsliste hinzufügen"       72
    "Ein paar Tropfen Flüssigkeit zeigen sich unter dem Konstruktionsaggregat."           "Leck"                     "Mittel"       "Zur Beobachtungsliste hinzufügen"       63
    "Einige Materialien, die vom Konstruktionsaggregat erzeugt werden, sind verdreht."    "Mechanischer Fehler"      "Niedrig"      "Maschine neu einstellen"                44
    "Eine Sicherung in der Controller-Montage ist durchgebrannt."                         "Elektrischer Fehler"      "Niedrig"      "Komponenten ersetzen"                  348
    "Im Mischer ist eine Sicherung durchgebrannt."                                        "Elektrischer Fehler"      "Niedrig"      "Komponenten ersetzen"                  441
    "Es ist ein schlagendes Geräusch zu hören im Zylinder Konstruktionsaggregat."         "Mechanischer Fehler"      "Mittel"       "Maschine neu einstellen"                35
    "Der Scanner produziert seltsame elektrische Geräusche."                              "Elektrischer Fehler"      "Niedrig"      "Zur Beobachtungsliste hinzufügen"       80
    "Abnormales Überhitzen der Sortieranlage."                                            "Leck"                     "Hoch"         "Vollständiger Ersatz"                 9000
変数 Beschreibung からテキスト データ (工場イベントの説明) を抽出します。
textData = data.Beschreibung;
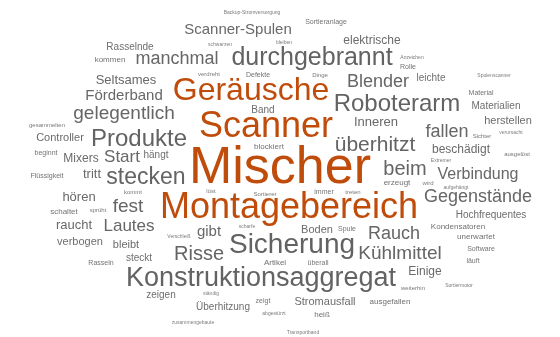
テキスト データをワード クラウドで可視化します。
figure
wordcloud(textData);
テキスト データのトークン化
tokenizedDocument 関数を使用して、トークン化された文書の配列を作成します。
documents = tokenizedDocument(textData);
documents(1:10)
ans =
  10×1 tokenizedDocument:

    11 tokens: Im Inneren des Mixers ist ein lautes Rasseln zu hören .
    10 tokens: Ein paar Tropfen Flüssigkeit zeigen sich unter dem Konstruktionsaggregat .
    12 tokens: Einige Materialien , die vom Konstruktionsaggregat erzeugt werden , sind verdreht .
     8 tokens: Eine Sicherung in der Controller-Montage ist durchgebrannt .
     7 tokens: Im Mischer ist eine Sicherung durchgebrannt .
    11 tokens: Es ist ein schlagendes Geräusch zu hören im Zylinder Konstruktionsaggregat .
     7 tokens: Der Scanner produziert seltsame elektrische Geräusche .
     5 tokens: Abnormales Überhitzen der Sortieranlage .
     6 tokens: Akustisches elektrisches Geräusch im Arbeitsagenten .
    12 tokens: Nach der Installation der Software ist keine Verbindung zum Netzwerk möglich .
品詞タグの取得
addPartOfSpeechDetails 関数を使用して、品詞の詳細を追加します。
documents = addPartOfSpeechDetails(documents);
トークンの詳細を取得し、最初のいくつかのトークンの詳細を表示します。
tdetails = tokenDetails(documents);
head(tdetails)
      Token      DocumentNumber    SentenceNumber    LineNumber     Type      Language    PartOfSpeech
    _________    ______________    ______________    __________    _______    ________    ____________

    "In"               1                 1               1         letters       de        adposition
    "dem"              1                 1               1         letters       de        determiner
    "Inneren"          1                 1               1         letters       de        noun
    "des"              1                 1               1         letters       de        determiner
    "Mixers"           1                 1               1         letters       de        noun
    "ist"              1                 1               1         letters       de        verb
    "ein"              1                 1               1         letters       de        determiner
    "lautes"           1                 1               1         letters       de        adjective
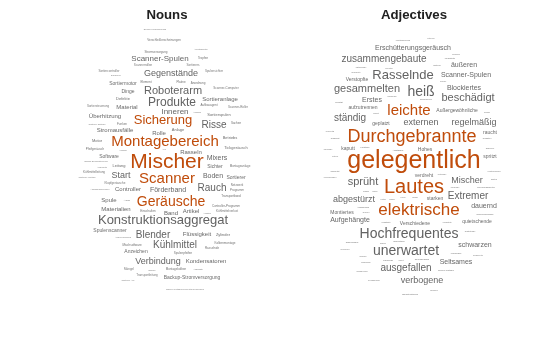
table の変数 PartOfSpeech には、トークンの品詞タグが格納されています。すべての名詞と形容詞のワード クラウドをそれぞれ作成します。
figure
idx = tdetails.PartOfSpeech == "noun";
tokens = tdetails.Token(idx);
subplot(1,2,1)
wordcloud(tokens);
title("Nouns")

idx = tdetails.PartOfSpeech == "adjective";
tokens = tdetails.Token(idx);
subplot(1,2,2)
wordcloud(tokens);
title("Adjectives")
解析用のテキスト データの準備
tokenizedDocument を使用してテキストをトークン化し、最初のいくつかの文書を表示します。
documentsRaw = tokenizedDocument(textData);
documents = documentsRaw;
documents(1:10)
ans =
  10×1 tokenizedDocument:

    11 tokens: Im Inneren des Mixers ist ein lautes Rasseln zu hören .
    10 tokens: Ein paar Tropfen Flüssigkeit zeigen sich unter dem Konstruktionsaggregat .
    12 tokens: Einige Materialien , die vom Konstruktionsaggregat erzeugt werden , sind verdreht .
     8 tokens: Eine Sicherung in der Controller-Montage ist durchgebrannt .
     7 tokens: Im Mischer ist eine Sicherung durchgebrannt .
    11 tokens: Es ist ein schlagendes Geräusch zu hören im Zylinder Konstruktionsaggregat .
     7 tokens: Der Scanner produziert seltsame elektrische Geräusche .
     5 tokens: Abnormales Überhitzen der Sortieranlage .
     6 tokens: Akustisches elektrisches Geräusch im Arbeitsagenten .
    12 tokens: Nach der Installation der Software ist keine Verbindung zum Netzwerk möglich .
ストップ ワードを削除します。
documents = removeStopWords(documents);
documents(1:10)
ans =
  10×1 tokenizedDocument:

    6 tokens: Inneren Mixers lautes Rasseln hören .
    6 tokens: paar Tropfen Flüssigkeit zeigen Konstruktionsaggregat .
    8 tokens: Einige Materialien , Konstruktionsaggregat erzeugt , verdreht .
    4 tokens: Sicherung Controller-Montage durchgebrannt .
    4 tokens: Mischer Sicherung durchgebrannt .
    6 tokens: schlagendes Geräusch hören Zylinder Konstruktionsaggregat .
    6 tokens: Scanner produziert seltsame elektrische Geräusche .
    4 tokens: Abnormales Überhitzen Sortieranlage .
    5 tokens: Akustisches elektrisches Geräusch Arbeitsagenten .
    6 tokens: Installation Software Verbindung Netzwerk möglich .
normalizeWords 関数を使用してテキストを正規化します。
documents = normalizeWords(documents);
documents(1:10)
ans =
  10×1 tokenizedDocument:

    6 tokens: inn mix laut rasseln hor .
    6 tokens: paar tropf flussig zeig konstruktionsaggregat .
    8 tokens: einig materiali , konstruktionsaggregat erzeugt , verdreht .
    4 tokens: sicher controller-montag durchgebrannt .
    4 tokens: misch sicher durchgebrannt .
    6 tokens: schlagend gerausch hor zylind konstruktionsaggregat .
    6 tokens: scann produziert seltsam elektr gerausch .
    4 tokens: abnormal uberhitz sortieranlag .
    5 tokens: akust elektr gerausch arbeitsagent .
    6 tokens: installation softwar verbind netzwerk moglich .
関数 erasePunctuation を使用して句読点を消去します。
documents = erasePunctuation(documents);
documents(1:10)
ans =
  10×1 tokenizedDocument:

    5 tokens: inn mix laut rasseln hor
    5 tokens: paar tropf flussig zeig konstruktionsaggregat
    5 tokens: einig materiali konstruktionsaggregat erzeugt verdreht
    3 tokens: sicher controllermontag durchgebrannt
    3 tokens: misch sicher durchgebrannt
    5 tokens: schlagend gerausch hor zylind konstruktionsaggregat
    5 tokens: scann produziert seltsam elektr gerausch
    3 tokens: abnormal uberhitz sortieranlag
    4 tokens: akust elektr gerausch arbeitsagent
    5 tokens: installation softwar verbind netzwerk moglich
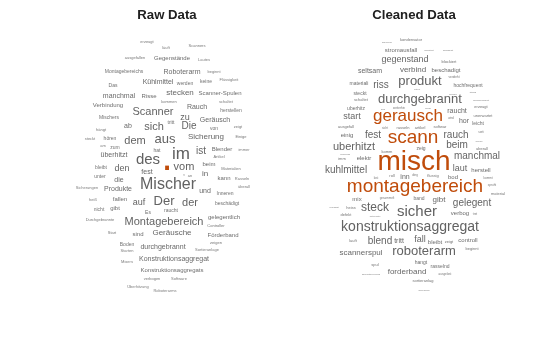
生データとクリーニング済みデータをワード クラウドで可視化します。
figure
subplot(1,2,1)
wordcloud(documentsRaw);
title("Raw Data")

subplot(1,2,2)
wordcloud(documents);
title("Cleaned Data")
前処理関数の作成
前処理を実行する関数を作成すると、さまざまなテキスト データのコレクションを同じ方法で準備するのに役立ちます。たとえば、1 つの関数を使用して、学習データと同じ手順で新しいデータを前処理することができます。
解析に使用するテキスト データをトークン化して前処理する関数を作成します。例の最後にリストされている関数 preprocessGermanText は以下のステップを実行します。
tokenizedDocumentを使用してテキストをトークン化する。removeStopWordsを使用して、ストップ ワード („der*“、„die“、„das“* など) のリストを削除する。normalizeWordsを使用して単語を正規化する。erasePunctuationを使用して句読点を消去する。
関数 removeEmptyDocuments を使用して前処理を行った後、空の文書を削除します。タイムスタンプやラベルなどの独立した配列に格納されたデータを関連付けた場合は、これに対応する要素も削除します。削除する要素のインデックスを取得するには、削除されたドキュメントのインデックスも返します。
この例では、例の最後にリストされている前処理関数 preprocessGermanText を使用して、テキスト データを準備します。
documents = preprocessGermanText(textData);
documents(1:5)
ans =
  5×1 tokenizedDocument:

    5 tokens: inn mix laut rasseln hor
    5 tokens: paar tropf flussig zeig konstruktionsaggregat
    5 tokens: einig materiali konstruktionsaggregat erzeugt verdreht
    3 tokens: sicher controllermontag durchgebrannt
    3 tokens: misch sicher durchgebrannt
関数 removeEmptyDocuments を使用して空の文書を削除します。
documents = removeEmptyDocuments(documents);
トピック モデルを当てはめる
潜在的ディリクレ配分 (LDA) トピック モデルをデータに当てはめます。LDA モデルは、文書のコレクションに内在するトピックを発見し、トピック内の単語の確率を推測します。
LDA モデルをデータに当てはめるには、まず bag-of-words モデルを作成しなければなりません。bag-of-words モデル (用語頻度カウンターとも呼ばれる) は、コレクションの各文書内で単語が出現する回数を記録します。bagOfWords を使用して bag-of-words モデルを作成します。
bag = bagOfWords(documents);
bag-of-words モデルから空の文書を削除します。
bag = removeEmptyDocuments(bag);
fitlda を使用して、トピック数 7 の LDA モデルを当てはめます。詳細出力を抑制するには、'Verbose' を 0 に設定します。
numTopics = 7;
mdl = fitlda(bag,numTopics,Verbose=0);
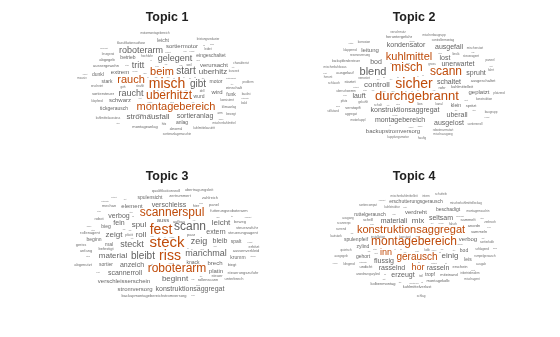
ワード クラウドを使用して、最初の 4 つのトピックを可視化します。
figure
for i = 1:4
    subplot(2,2,i)
    wordcloud(mdl,i);
    title("Topic " + i)
end
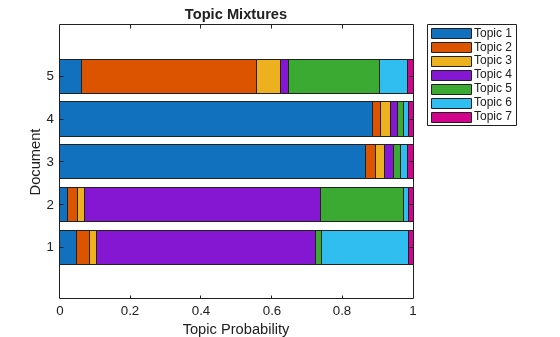
積み上げ棒グラフを使用して、複数のトピックの混合率を可視化します。ランダムに 5 つの入力文書を表示し、対応するトピックの混合率を可視化します。
numDocuments = numel(documents);
idx = randperm(numDocuments,5);
documents(idx)
ans =
  5×1 tokenizedDocument:

    4 tokens: seltsam rasseln intern misch
    4 tokens: ausstoss konstruktionsaggregat sammelt flussig
    3 tokens: abnormal uberhitz sortieranlag
    4 tokens: roboterarm gibt schwarz rauch
    3 tokens: misch schaltet manchmal
topicMixtures = transform(mdl,documents(idx));

figure
barh(topicMixtures(1:5,:),"stacked")
xlim([0 1])
title("Topic Mixtures")
xlabel("Topic Probability")
ylabel("Document")
legend("Topic " + string(1:numTopics),Location="northeastoutside")
例の前処理関数
関数 preprocessGermanText は以下のステップを実行します。
tokenizedDocumentを使用してテキストをトークン化する。removeStopWordsを使用して、ストップ ワード („der*“、„die“、„das“* など) のリストを削除する。normalizeWordsを使用して単語を正規化する。erasePunctuationを使用して句読点を消去する。
function documents = preprocessGermanText(textData)

% Tokenize the text.
documents = tokenizedDocument(textData);

% Remove a list of stop words.
documents = removeStopWords(documents);

% Normalize the words.
documents = normalizeWords(documents);

% Erase the punctuation.
documents = erasePunctuation(documents);

end
参考
tokenizedDocument | removeStopWords | stopWords | addPartOfSpeechDetails | tokenDetails | normalizeWords

